ノードが29時間、静かに消えていた — GB10クラスタのNIC障害(Realtek r8127 TXタイムアウト)を突き止めるまで
シリーズ: 自宅LLMクラスタ 前回: DeepSeek-V4-Flash 正式版(0731)移行記 / 第1作: 人間はケーブルを挿すだけ
時系列としては、この話は第1作(7月のクラスタ建立)と前回(8月中旬のモデル移行)の間、8月頭の出来事です。前回の記事で「ノードの1台が29時間『行方不明』になる障害があった」と一行だけ触れた、その調査の全記録になります。
結論から書きます。犯人はNIC(Realtek r8127)のドライバ層で、TXタイムアウト→デバイスリセット→リンク喪失→再ネゴシエーション失敗という、NICの中で完結した障害でした。しかし、そこへたどり着くまでに私は仮説を3回立てて2回撤回し、途中で「実は犯人は自分だったかもしれない」という証言まで飛び出します。障害調査の教科書的な美しい一直線ではなく、行きつ戻りつの記録として書きます。同じような自宅クラスタを運用している方の、いつかの深夜の参考になれば。
序章: 発見が29時間後だった理由
発見の瞬間から妙でした。死活監視(Uptime Kuma)を整備している真っ最中に、Tailscaleの管理画面で2号機(edgexpert)が「16時間オフライン」と表示されていることに気づいたのです。監視を作っている足元で、監視すべき障害がとっくに起きていた。
最初は表示を疑いました。というのも、クラスタは毎日使っていたからです。2台跨ぎ(TP=2)で動くLLMに毎日推論を投げ、毎日返事が来ていた。ノードが半日以上死んでいるなら気づかないはずがない——そう思っていました。
調査の結果、Tailscaleの表示はほぼ正確でした。edgexpertは8月4日18時14分に物理リンク(carrier)を失い、そのまま約29時間、ネットワークから消えていました。OSは生きていて、ログも取れていて、しかし誰からも見えない。
ではなぜ推論が動き続けていたのか。ここがこのクラスタの構造の面白いところで、ノード間は200GのDACケーブルで直結されており、管理LAN(宅内ハブ経由の1G系)とは完全に別配線です。死んだのは管理LAN側だけで、推論トラフィックが流れるインターコネクトは29時間ずっと生きていました。後にgx10側のカーネルログで裏付けが取れます——インターコネクトのリンクが落ちたのは、復旧のために私がedgexpertの電源を落としたその瞬間だけ。つまりDSV4は障害の間、一度も止まっていなかった。気づけなかったのは当然でした。
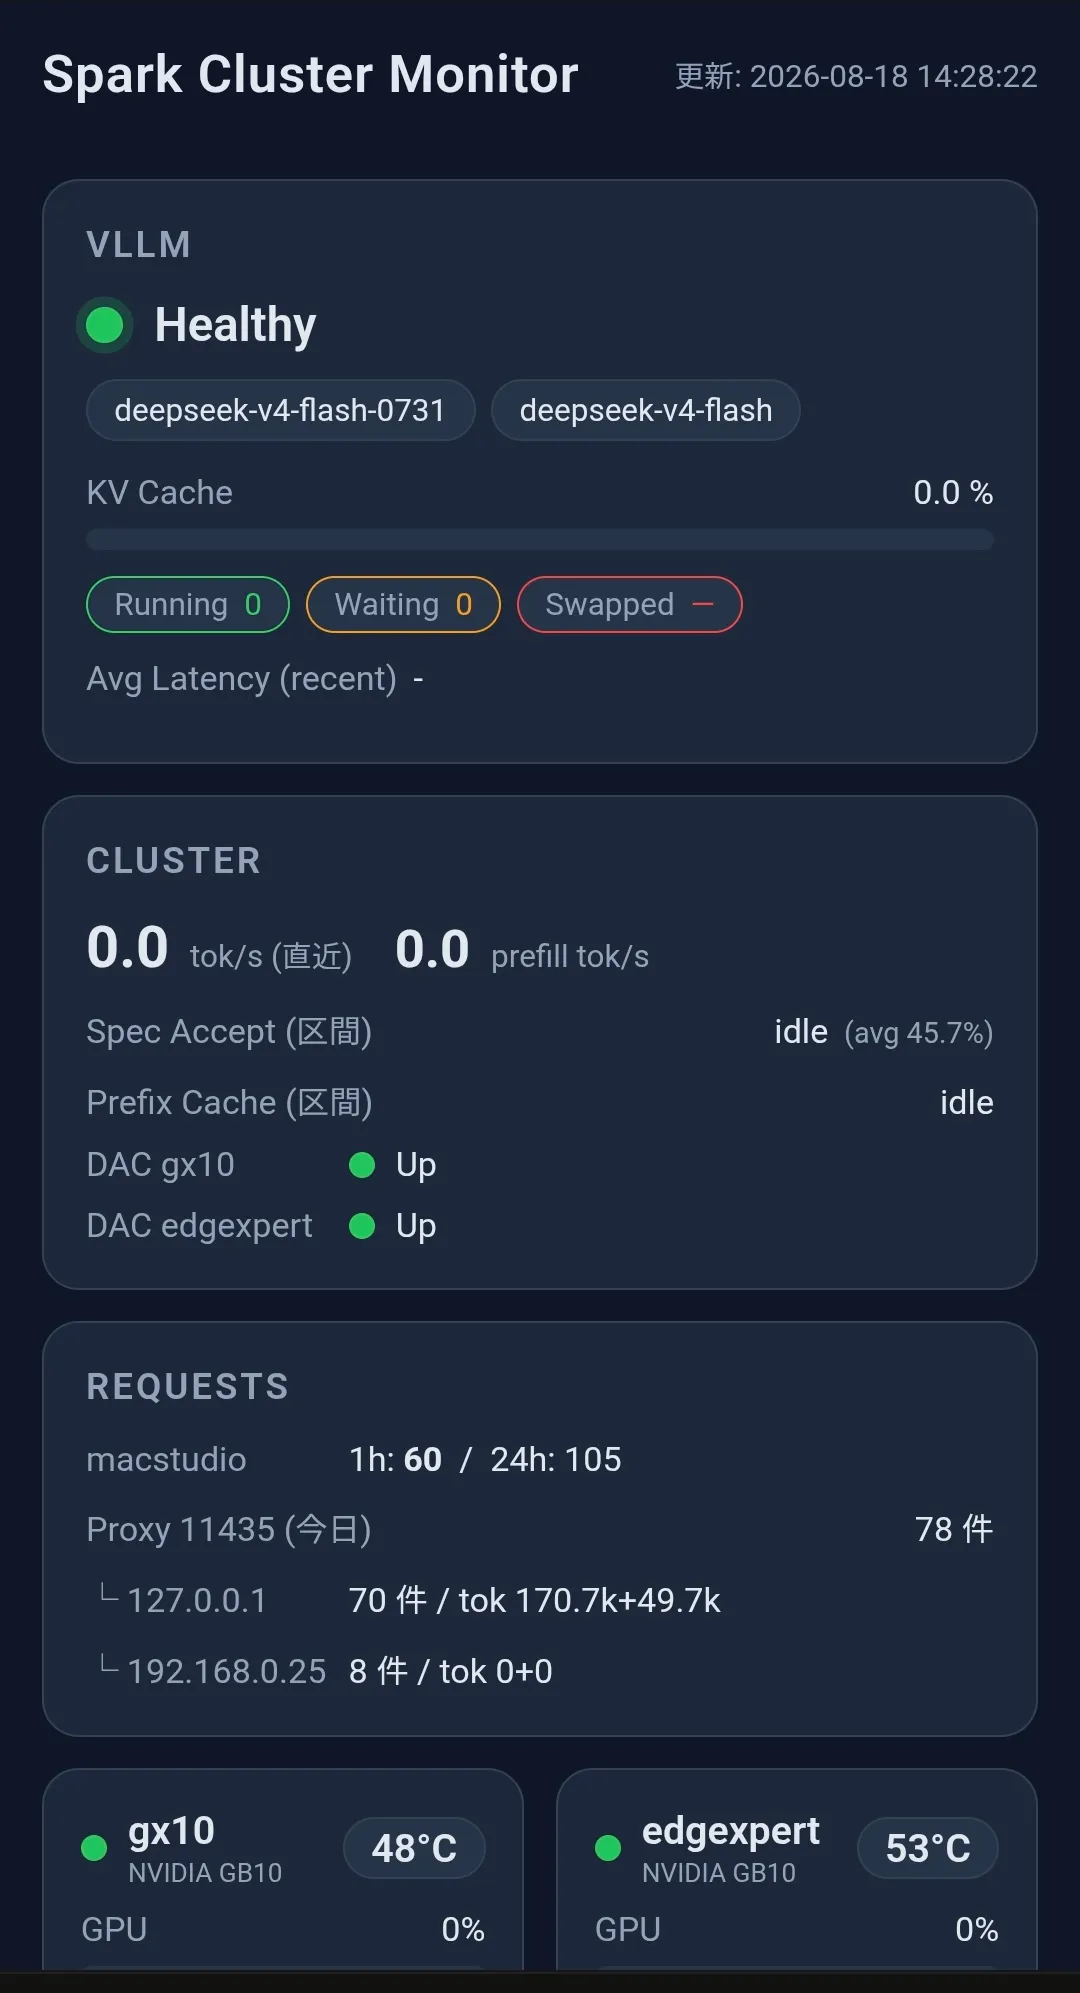
さらに皮肉なことに、クラスタ監視ダッシュボードのedgexpert監視もDAC経由で見ていたため、障害中ずっと「online」と表示していました。監視はあった。ただ、死んだ層を見ていなかった。この「監視がある」と「その層を見ている」は別物、という教訓は、前回の記事で6週間死んでいたbotを見つけたときにも再登場します。初出はこの障害でした。
第1章: 容疑者が現れては消える
原因調査は仮説の墓場でした。時系列ではなく、容疑者別に整理します。
容疑者1: NetworkManagerのプロファイル重複。edgexpertの管理LANには自動生成プロファイルが重複しており、まずこれを疑いました。しかし7月15日に起きた一過性のリンクフラップでは、同じプロファイル構成のまま自動復帰に成功している。設定が汚いことと、今回復帰できなかったことの間に因果はない——無罪。ただし設定の汚さ自体は事実なので、恒久対策(後述)の対象には残しました。
容疑者2: 宅内ハブ(または配線)。調査中に決定的な証言が出ます。同じ日の夕方、Mac StudioのLANも切れていて、私自身がケーブルを差し直して直していたのです。すっかり忘れていました。同じ晩に2台が物理リンクを失った——これはスイッチか配線の共通イベントではないか。一時はハブ交換を「実施推奨」まで格上げしました。
しかしこの説は時刻の精査で崩れます。Mac Studioの断は17時43分01秒、edgexpertの断は18時13分59秒。31分差。同一の物理イベントで説明するには離れすぎています。さらに後述のカーネルログで、edgexpert側は「ハブからリンクを落とされた」のではなく「NICが自分でリセットした」ことが確定し、ハブは「積極的に交換する理由なし」に降格しました(将来買い替えるならログの取れる機種にすると切り分けが楽、という程度)。
容疑者3: 宅内環境が定常的に瞬断している説。調査の過程で、Windows機の有線リンクが毎日1〜4回「瞬断」しているログが見つかり、一時は「この家のネットワークは常にフラップしている」と青ざめました。これも撤回します。Power-Troubleshooterのログと突合すると、瞬断9件はすべてスリープ復帰の時刻と秒単位で一致。リンクの瞬断に見えたものは、マシンが起きるときの副産物でした。最初にKernel-Powerのイベント時刻だけで判断したのが誤りで、実際このマシンは毎回数十分〜8時間まとめて寝ていた。「スリープじゃないか?」という素朴な第一勘を一度否定し、より詳しいログで復活させた、行って戻った仮説です。
余談ですが、このWindows機は障害の晩、有線の到達性を失ってWi-Fiに静かにフェイルオーバーしており、Mac Studioのケーブルを差し直した瞬間(19時23分03秒)に有線へ戻っていました。家庭内のネットワークは、思っているより多くのことが人知れず起きています。
第2章: 真犯人はNICの中にいた
決着はedgexpertのカーネルログでした。8月4日18時13分59秒、Realtek r8127ドライバがTXタイムアウトを検出し、デバイスリセットを実行、その結果carrierを喪失し、以後の再ネゴシエーションに失敗し続けていた。外部から落とされた形跡はなく、NICとドライバの中で完結した障害です。7月のフラップでは復帰できたのに今回はできなかった理由も、リセットからの再ネゴ失敗という経路なら説明がつきます。
対策の選択肢は多くありません。r8127はfwupd/LVFSの配布対象外で、ファームウェア更新という王道が使えない。カーネル/ドライバ側の改善を待つ層の問題です。できることとして、gx10側に1件来ていたEC(組み込みコントローラ)更新の適用と、両ノードのネットワーク設定の大掃除を実施しました——全イーサネットIFのnetplan明示定義化、自動生成プロファイルの全削除、デフォルトルートの1本化。この掃除の途中で、旧設定のDHCPループが約45秒周期でRDMAのGIDテーブル変更を起こしていた実害(NCCLログに痕跡)も見つかり、掃除は無駄ではありませんでした。
なおMac Studio側の断(17時43分)は「物理リンク層の断までは確定、その先は未特定」で決着としました。DHCPリース説は3つの反証で棄却できましたが、ケーブルかポートかハブかまでは詰め切れない。すべての謎が解けるわけではない、と記録に残して打ち切るのも調査のうちだと思っています。
第3章: 復旧作業の二次災害
オチがあります。障害の29時間、一度も止まらなかったDSV4は、復旧作業で止まりました。edgexpertの電源再投入で、--rmオプション付きで起動していたvLLMコンテナが消滅したのです。--rmは「終了時にコンテナを消す」——再起動をまたいで生きてほしい常駐には向かない起動方法でした。起動スクリプト一発で復旧しましたが、「ノード再起動後にクラスタが自動復帰しない」問題として宿題に登録しました。
調査中に踏んだ落とし穴も2つ記録しておきます。ひとつ、rayのray statusは死んだノードをActiveに表示し続けることがあります。生存確認はray.nodes()のAliveフラグで。ひとつ、macOSではzshの組み込みコマンドlogが/usr/bin/logを隠します。エラーを2>/dev/nullで握り潰していたことも重なって「ログが存在しない」と誤判定していました。ログツールは絶対パスで呼ぶこと。
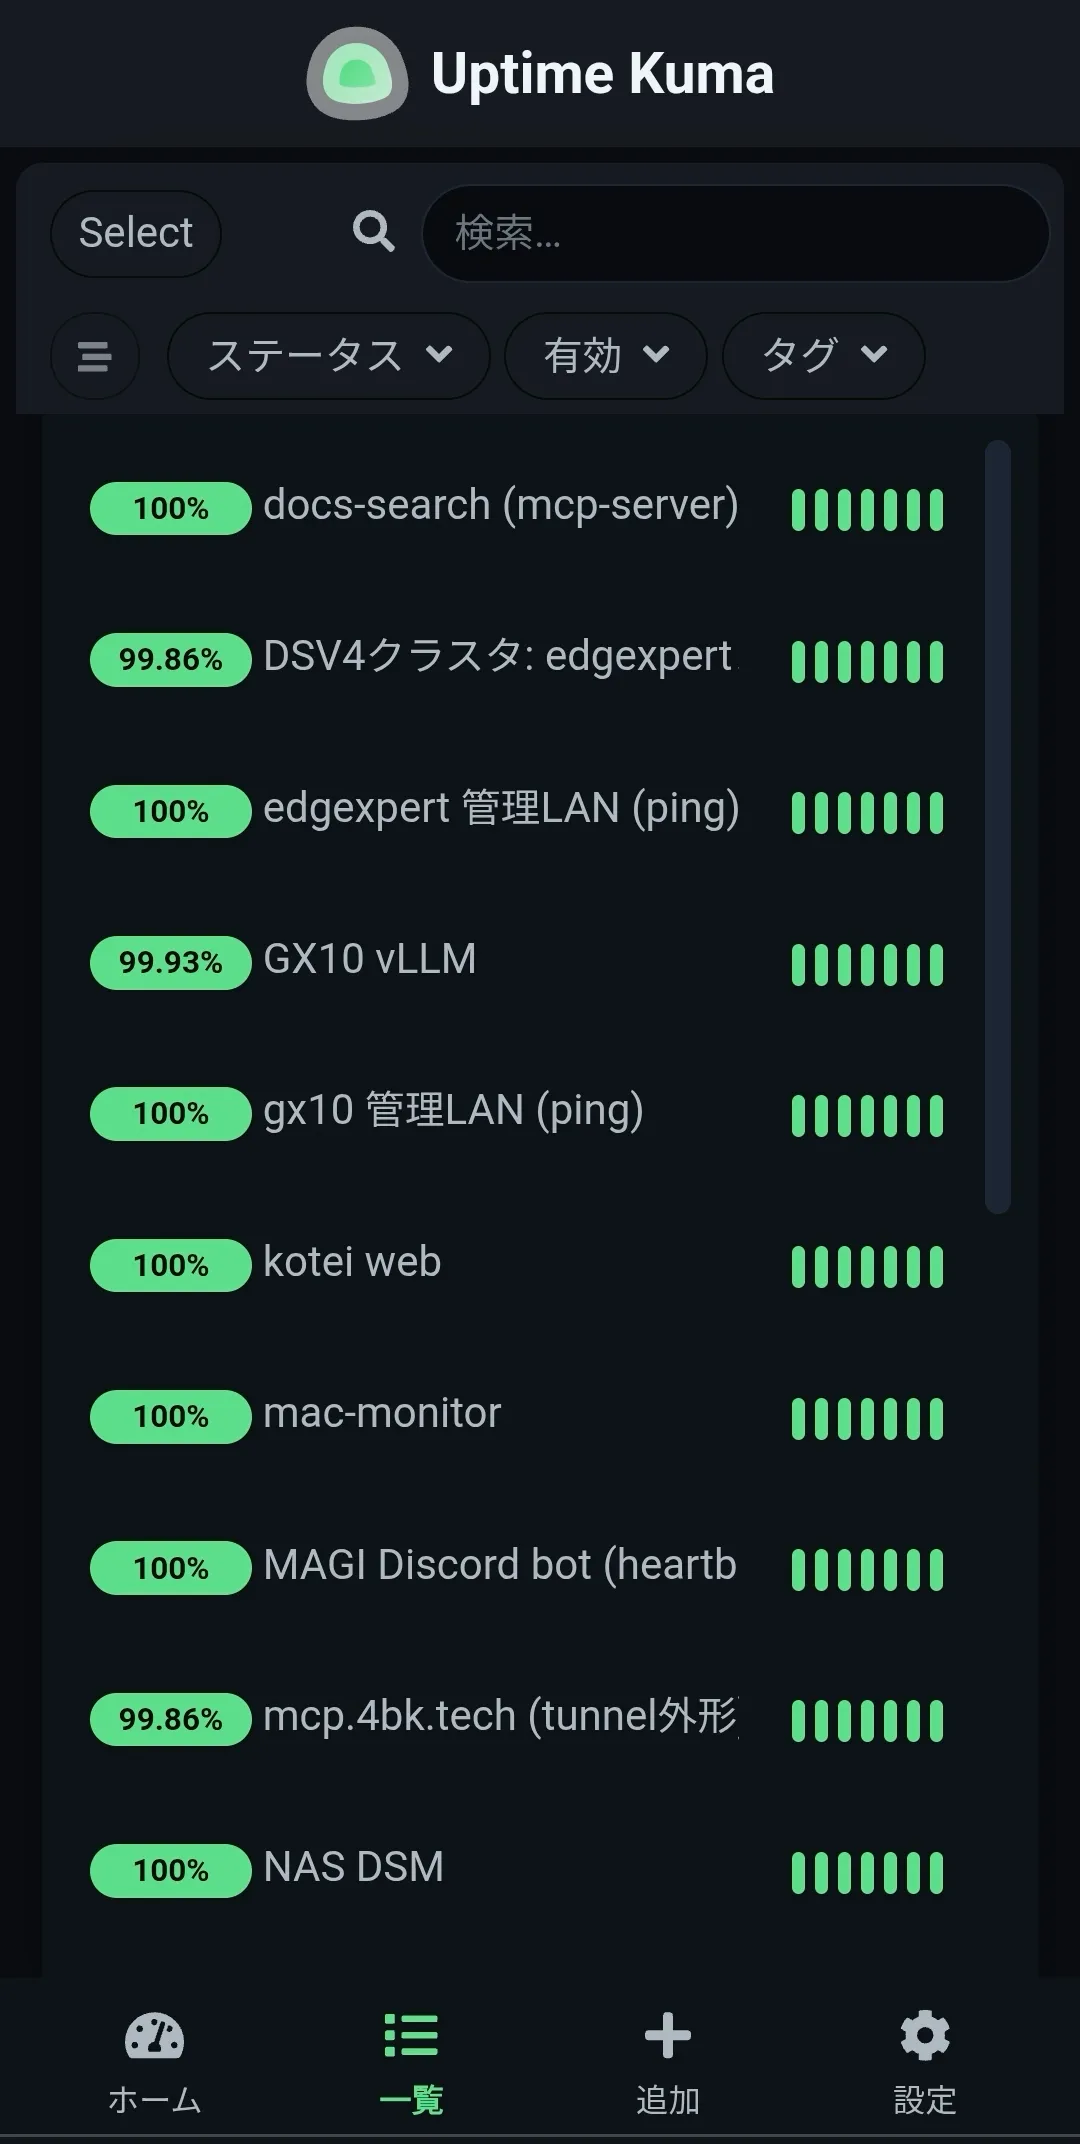
そして監視の作り直しです。今回の教訓「層を見ろ」をそのまま設計に落とし、Uptime Kumaの監視を層別に分離しました。管理LANの生死(ping)、クラスタのDAC面(内部ステータスAPIのkeyword監視)、サービス面(vLLMのHTTP)——それぞれ別のモニタにして、「管理面が死んだ」と「推論が死んだ」を区別して通知させる。障害中に「online」と言い続けたあの誤報は、嘘をついていたのではなく、聞かれたことに答えていただけでした。質問を層別に分けるのは監視側の仕事です。
終章: 5つの学び
- 二層ネットワークでは「動いている」は片層の証言にすぎない。推論が通ることと、ノードに到達できることは、別の配線の話でした
- 仮説は撤回してこそ前進する。ハブ犯人説もフラップ説も、否定できたことで捜査範囲が狭まりました。第1作で「事実に負けを認める」を人間の仕事に挙げましたが、これはその実践編です
- 時刻の突合が最強の証拠。31分差という数字ひとつが「共通イベント説」を葬りました。ログは読むものではなく突き合わせるもの
- 復旧作業そのものがリスク。29時間無停止だったシステムを止めたのは、障害ではなく私の電源ボタンでした。
--rmで常駐を起動しない - 監視は層別に。「監視がある」ことに安心せず、どの層への質問なのかを設計する
この障害調査で作った層別監視とテレメトリの上で、前回書いたモデル移行は走っています。転んだ順に書けなかったのは、起き上がるほうを先に記事にしたかったからです。
※機材構成の詳細(GB10 2ノード、200G DAC直結、管理LANの構成)は第1作を参照してください。障害はいずれも当環境固有の条件を含むため、同型機で同じ事象が起きるとは限りません。