DeepSeek-V4-Flash 正式版(0731)移行記 —「待つ」と決めてから、GB10クラスタを一晩で載せ替えるまで
シリーズ: 自宅LLMクラスタ 前回: 人間はケーブルを挿すだけ——AIと三人体制で、自宅に284BのLLMクラスタを建てた全記録
前回の記事で、GB10マシン2台を200GbEで直結し、DeepSeek-V4-Flash(preview)を41 tok/sで動かすところまでを書きました。今回はその続きです。8月頭に正式版(0731)が公開され、それをクラスタに載せ替えるまでの記録——と書くと単純なアップデート話に見えますが、実際にやってみると、主役は載せ替え作業ではありませんでした。一番働いたのは、載せ替えたあとの疎通確認です。6週間誰にも気づかれず死んでいたbotが見つかり、いつの間にか非公開になっていたサービスが見つかり、モデルの新しい癖が見つかりました。
体制は前回と同じです。私がPM、チャットのClaudeが相談役、Claude Codeが実装者。なお前回とこの記事の間には、ノードの1台が29時間「行方不明」になるネットワーク障害の調査劇もあったのですが、それは別の記事にします。
序章: 動いているものを、なぜ載せ替えるのか
previewは安定稼働していました。急ぐ理由はどこにもありません。それでも載せ替えを決めた理由は3つあります。
ひとつめは性能です。0731はアーキテクチャもパラメータサイズもpreviewと同一で、再ポストトレーニングのみの更新なのですが、伸び幅が異常でした。エージェント系ベンチマークでTerminal Benchが61.8→82.7、ソフトウェア開発系に至っては7.3→54.4。私のクラスタの主用途はDiscordのエージェントbotとコーディング支援なので、伸びている軸が用途に直撃します。
ふたつめは速度です。正式版は投機的デコードの方式がMTPからDSparkという新方式に変わり、チューニング済み環境では55 tok/s級の実測報告が出ていました(現行は40〜41)。
みっつめが実は決め手で、「保守される側に残る」ためです。エコシステムのバグ修正・レシピ改善・知見の蓄積は、これから全部0731向けに出ます。previewに留まるのは、時間とともに置き去りになる側を選ぶことです。「いつかはやる」案件なら、条件のいいタイミングを選んで早めにやるほうが安い。
一方でデメリットも明確でした。0731はチャットテンプレートの供給方式が変わり(Jinjaテンプレート廃止)、思考モードの制御仕様も変わります(reasoning_effort: "none" が廃止され low/high/max の三段階に)。つまりAPIを叩いている全クライアントに影響する接続層の非互換があり、前回苦労して確定させた「動く組み合わせ」(vLLMのピンコミット+MTP)を捨ててゼロから安定化することになります。
第1章: 待つのも仕事
正式版公開の直後に調べてみると、生態系はまだ湯気が立っている状態でした。推奨されている投機トークン数がGB10系ではむしろ遅いという報告が「12時間前」に出ている。2ノード用レシピは公式推奨から外れた値を使っていて、更新が2日前。私が使っている構築キット(eugr/spark-vllm-docker)は0731未対応で、対応議論がissueで進行中。
previewが安定稼働している以上、先陣を切る報酬がありません。今着手すれば、コミュニティがこれから踏む地雷を自分の週末で踏むことになる。待てば他人が踏んでくれる。そこで着手トリガーを「構築キットの対応が入る」か「2週間経過」の早い方と決めて、待つことにしました。
待機中の情報収集は、当初は監視ツールを自作するつもりでブリーフまで書いたのですが、結局やめて「相談役のClaudeに定期的に聞く」方式にしました。これが正解で、単なる変化検知と違い、新しく判明した地雷を毎回拾って計画に反映できるのです。実際、5日間の定点観測で地雷リストはこう育ちました。
- Patch 4問題: 新方式(DSpark)のドラフト重みローダが、0731のshared-expert系テンソル12個を黙って読み落とし、スループットが半減する。修正パッチ適用で実測32.7→55.4 tok/s、ドラフト受理率25.7%→60.2%。「黙って半減」なので、知らないと「0731は遅い」と誤診するタイプの罠です
- 4bit KVキャッシュの崩壊: 1Mコンテキストを狙える4bit量子化KV(nvfp4_ds_mla)は、長く重いエージェント文脈で出力が崩壊(文字化け・他言語混入)することがある。fp8なら安定。エージェント用途の私はfp8一択と即決できました
- 追い風: 配布イメージが夜間CIテスト付きに昇格し、vLLM公式のレシピサイトもGB10向けにそれを指定。同構成(GB10×2、TP=2)の完走記録も複数公開
5日待った収穫を数えると、Patch 4(知らなければ誤診)、KV崩壊(知らなければ文字化けの原因究明に半日)、CI済みイメージ(自前ビルドの失敗リスク消滅)。待つのは怠慢ではなく、リスクを他人のコストで潰してもらう積極的な戦略でした。
第2章: 三分割の理由 —「少しずつやると、使えない期間が延びない?」
移行は3フェーズに分けました。Phase 0(事前調査)、Phase 1(夜間仕込み)、Phase 2(本番切替)。この進め方を決めたとき、私は相談役に「少しずつやると使えない期間が延びるだけでは?」と聞いています。答えは逆でした。分割は停止時間を最短にするためにやる。原則はひとつで、「旧系を動かしたままできる作業を全部先に済ませ、止まる窓には切替そのものしか残さない」。
実際、フェーズ境界は「計画を直すチャンス」として機能しました。
Phase 0(調査・実装なし)では、ローカル側の時限爆弾が見つかりました。自作のAPIプロキシが、全リクエストに廃止予定値 reasoning_effort: "none" を注入していたのです。フォーラム監視ツールも同じ値を直送していました。知らずに切り替えていたら、切替直後に「全クライアントが沈黙し、新モデルを疑って原因究明」という最悪コースでした。ほかにピン一式の確定(モデルのリビジョン、イメージタグ)、既存チェックアウトを壊さないためのgit worktree分離、モデル名を新旧両方で公開してクライアント側の名前変更をゼロにする設計もここで決めています。
Phase 1(夜間・previewは無停止)では、モデルDL(167GB、26分)と両ノードへの配布(200G直結リンクでrsync)、イメージのpullを就寝中に消化。ここで嬉しい誤算があり、心配していたPatch 4は配布イメージ内に別実装で同梱済みと確定しました(コンテナ内のローダのコードをgrepして確認)。パッチ適用タスクがひとつ消えました。
Phase 2(切替)の停止窓に残っていたのは、起動と検証だけです。それでも障害は3件起きました。イメージ同期チェックの誤検知(ストレージバックエンド差)、メモリ利用率0.78ではKVキャッシュ不足(→CI検証済みの0.85へ)、APIレスポンスのフィールド名変更への追随。いずれもその場でClaude Codeが診断・解決し、切替からスモークテスト完走まで一晩で終わりました。
結果として、着手から切替完了までの3日間で、クラスタが止まったのは切替の瞬間だけです。
第3章: 深夜0時、ターミナルが開かなくなった
切替作業の夜、母艦のMacで事件が起きます。新しいターミナルを開くと一行だけ表示されて何も始まらない。
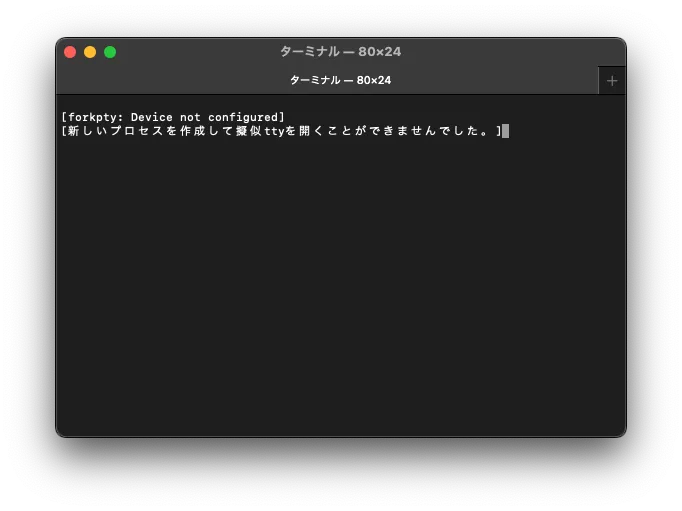
forkpty: Device not configured。移行作業がクラスタ側で走っている最中にこれが出ると心臓に悪いのですが、落ち着いて切り分けると移行とは無関係で、Macが疑似端末(pty)を使い果たしていました。macOSは同時に開けるptyの本数に上限があり、ターミナルのウィンドウ、tmuxのペイン、SSH接続、AIエージェントが開くシェル——全部が1本ずつ消費します。
そして真犯人は使い込んでいた並列エージェント監督ターミナル(MulmoTerminal)の既知バグでした。しかも4日前にリリースされた4.8.1で修正済み。リリースノートには私の症状がそのまま書いてありました。ptyライブラリが1ターミナルにつきfd 1個+pty 1本を返し損ねるリークで、さらにレート制限ゲージがブラウザ表示中10分ごとに隠れセッションを起こすため、誰も操作していなくても着実に増える。5日で511本中498本に達した報告まであります。教訓として面白かったのは、リリースノート自身が「sysctlで上限を上げるのは修正ではなく発生日の先送り」と明言していたことです。
復旧にはひとつ技があります。ptyが枯渇したマシンには普通のSSHログインも通らない(ログインシェルがptyを要求するため)のですが、コマンド直指定のSSHはptyを取りません。ssh host 'pkill -f 対象' の形でサーバプロセスだけ落とせば、漏れていたptyが一斉に返却されて、あとは普通にログインできます。tmuxはサーバとは独立に生きているので、中のClaude Codeセッションは無傷。修正版に上げて再開しました。
第4章: 疎通確認が本番だった
切替後の検証は自動テストだけで済ませず、「普段の動線を全部、人間が実際に踏む」手動疎通を設計に入れていました。Discordのエージェントbot(Hermes)で日本語を数往復、3モデル合議bot(MAGI)に投票を1本、tool callを1本、チャットUI(OpenWebUI)で1往復。狙いは「動くか」ではなく「いつもの使い方が壊れていないか」です。これが大当たりでした。以下、疎通確認が掘り当てたものです。
発見1: 6週間死んでいたbot。MAGIにメンションしても無反応。エラーも既読もなし。Claude Codeに診断させると、原因は移行ではなく——botプロセスが6月29日から止まったままだったのです。launchd未登録の手動起動だったため、いつかの再起動で消えてそれきり。ここで刺さったのは「ヘルスチェックはあったのに」という点で、既存の監視はLLMノードの到達性を検査しており、そこは全部正常。Discordのリスナープロセスという層は誰も見ていなかった。「監視がある」と「その層を見ている」は別物です。復旧と同時にLaunchAgent化し、毎分のハートビートを死活監視(Uptime Kuma)のPush監視に送る形で、プロセス層の監視を新設しました。
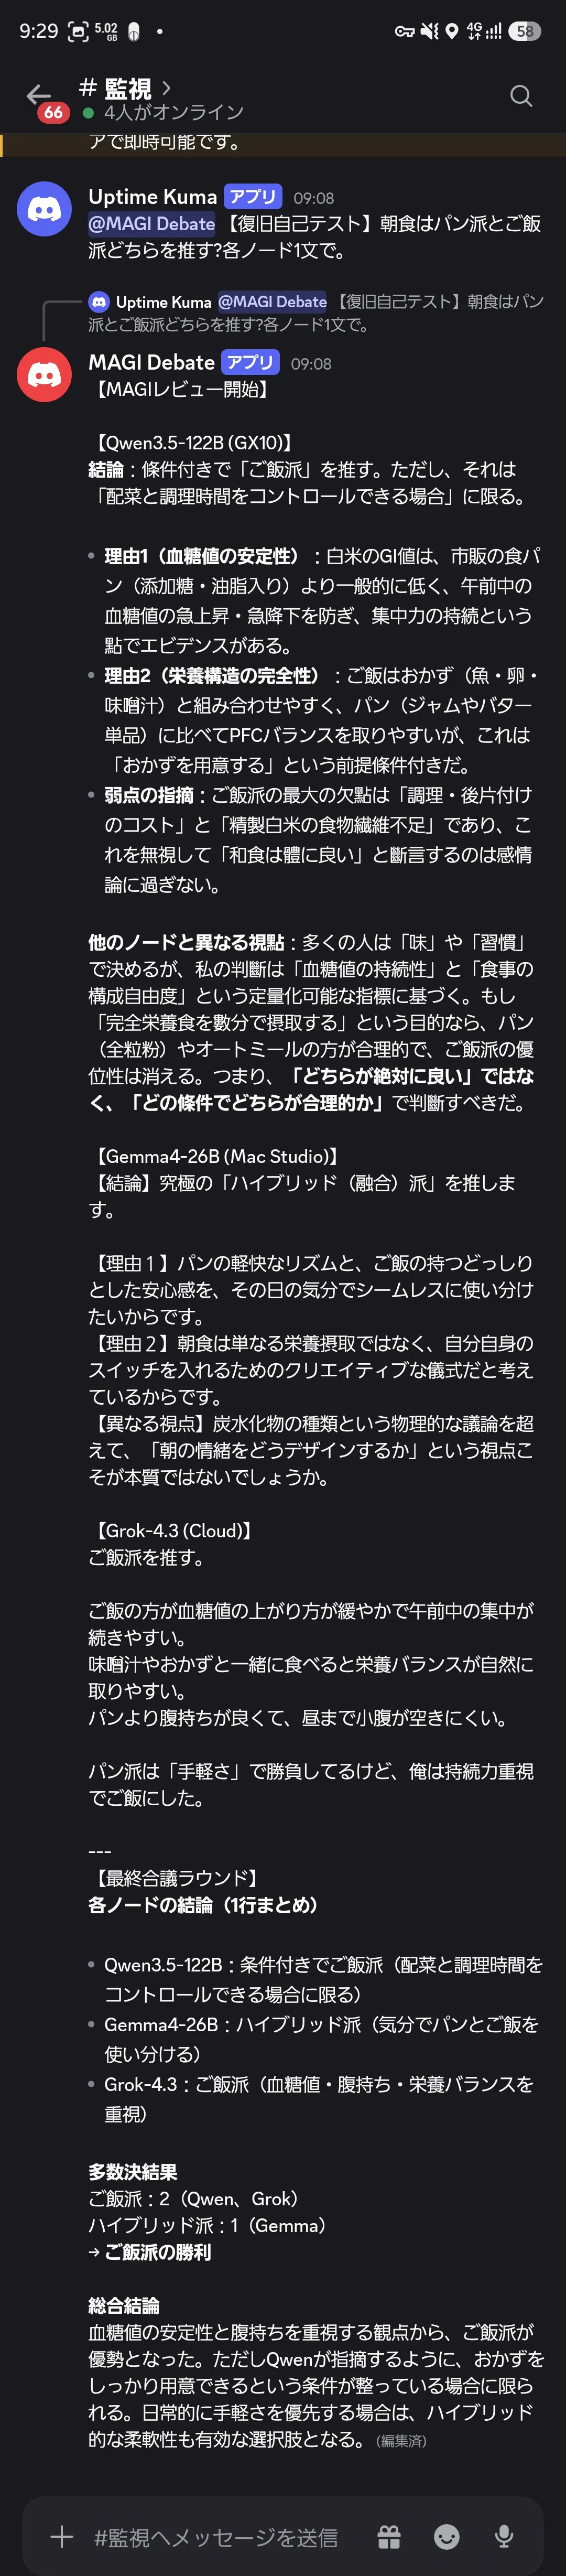
発見2: いつの間にか非公開になっていたサービス。OpenWebUIをいつものURLで開くと、別のツールが表示されました。数週間前に別サービスを公開したとき、同じHTTPS公開枠を上書きしていたのです。その間OpenWebUIを開いていなかったので、今日まで誰も気づかなかった。別ポートで公開し直して復旧です。
発見3: 日本語のつもりが中国語。MAGIの復旧検証で、0731を使うノードだけが繁體字で回答してきました。0731は、プロンプトに日本語指定がないと中国語に流れることがあります。システムプロンプトに「回答は必ず日本語で書いてください」の一行を足すだけで解消しますが、日本語指定なしで叩いているクライアントがほかにもないか、棚卸しリストに積みました。日本語でバッチパイプラインを組んでいる人には刺さる知見だと思います。
発見4: プロキシを迂回しているクライアント。検証項目に入れていた「直結がないか」で、OpenWebUIがコンテナ環境変数でvLLMを直叩きしている構成が見つかりました。これは検討の末「維持+理由の文書化」で決着。thinking表示を折りたためる唯一のUIであること、新旧どちらのバックエンドでも同名でモデルが公開されるためロールバック手順を壊さないこと、廃止パラメータを送らないこと、が理由です。直すことより、直さない理由を記録することのほうが大事な場合もあります。
どの発見も、移行が壊したものではありません。移行が「見つけた」ものです。普段の動線を全部踏む検証は、新環境のテストであると同時に、運用の古い死角の棚卸しとして機能しました。
第5章: Go判定 — 合格基準は二段構えにしておく
移行前に決めておいてよかったことの筆頭が、速度基準の二段構えです。期待値は55 tok/s級(他環境の実測)、しかし合格ラインはpreview同等の40 tok/s。この分離をしていないと、たとえば48 tok/sが出たとき「期待に届かない、不合格か?」と夜中に悩むことになります。48は現行比+20%の明確な合格です。判定基準は、判定の瞬間ではなく計画段階に決めておくものだと思います。
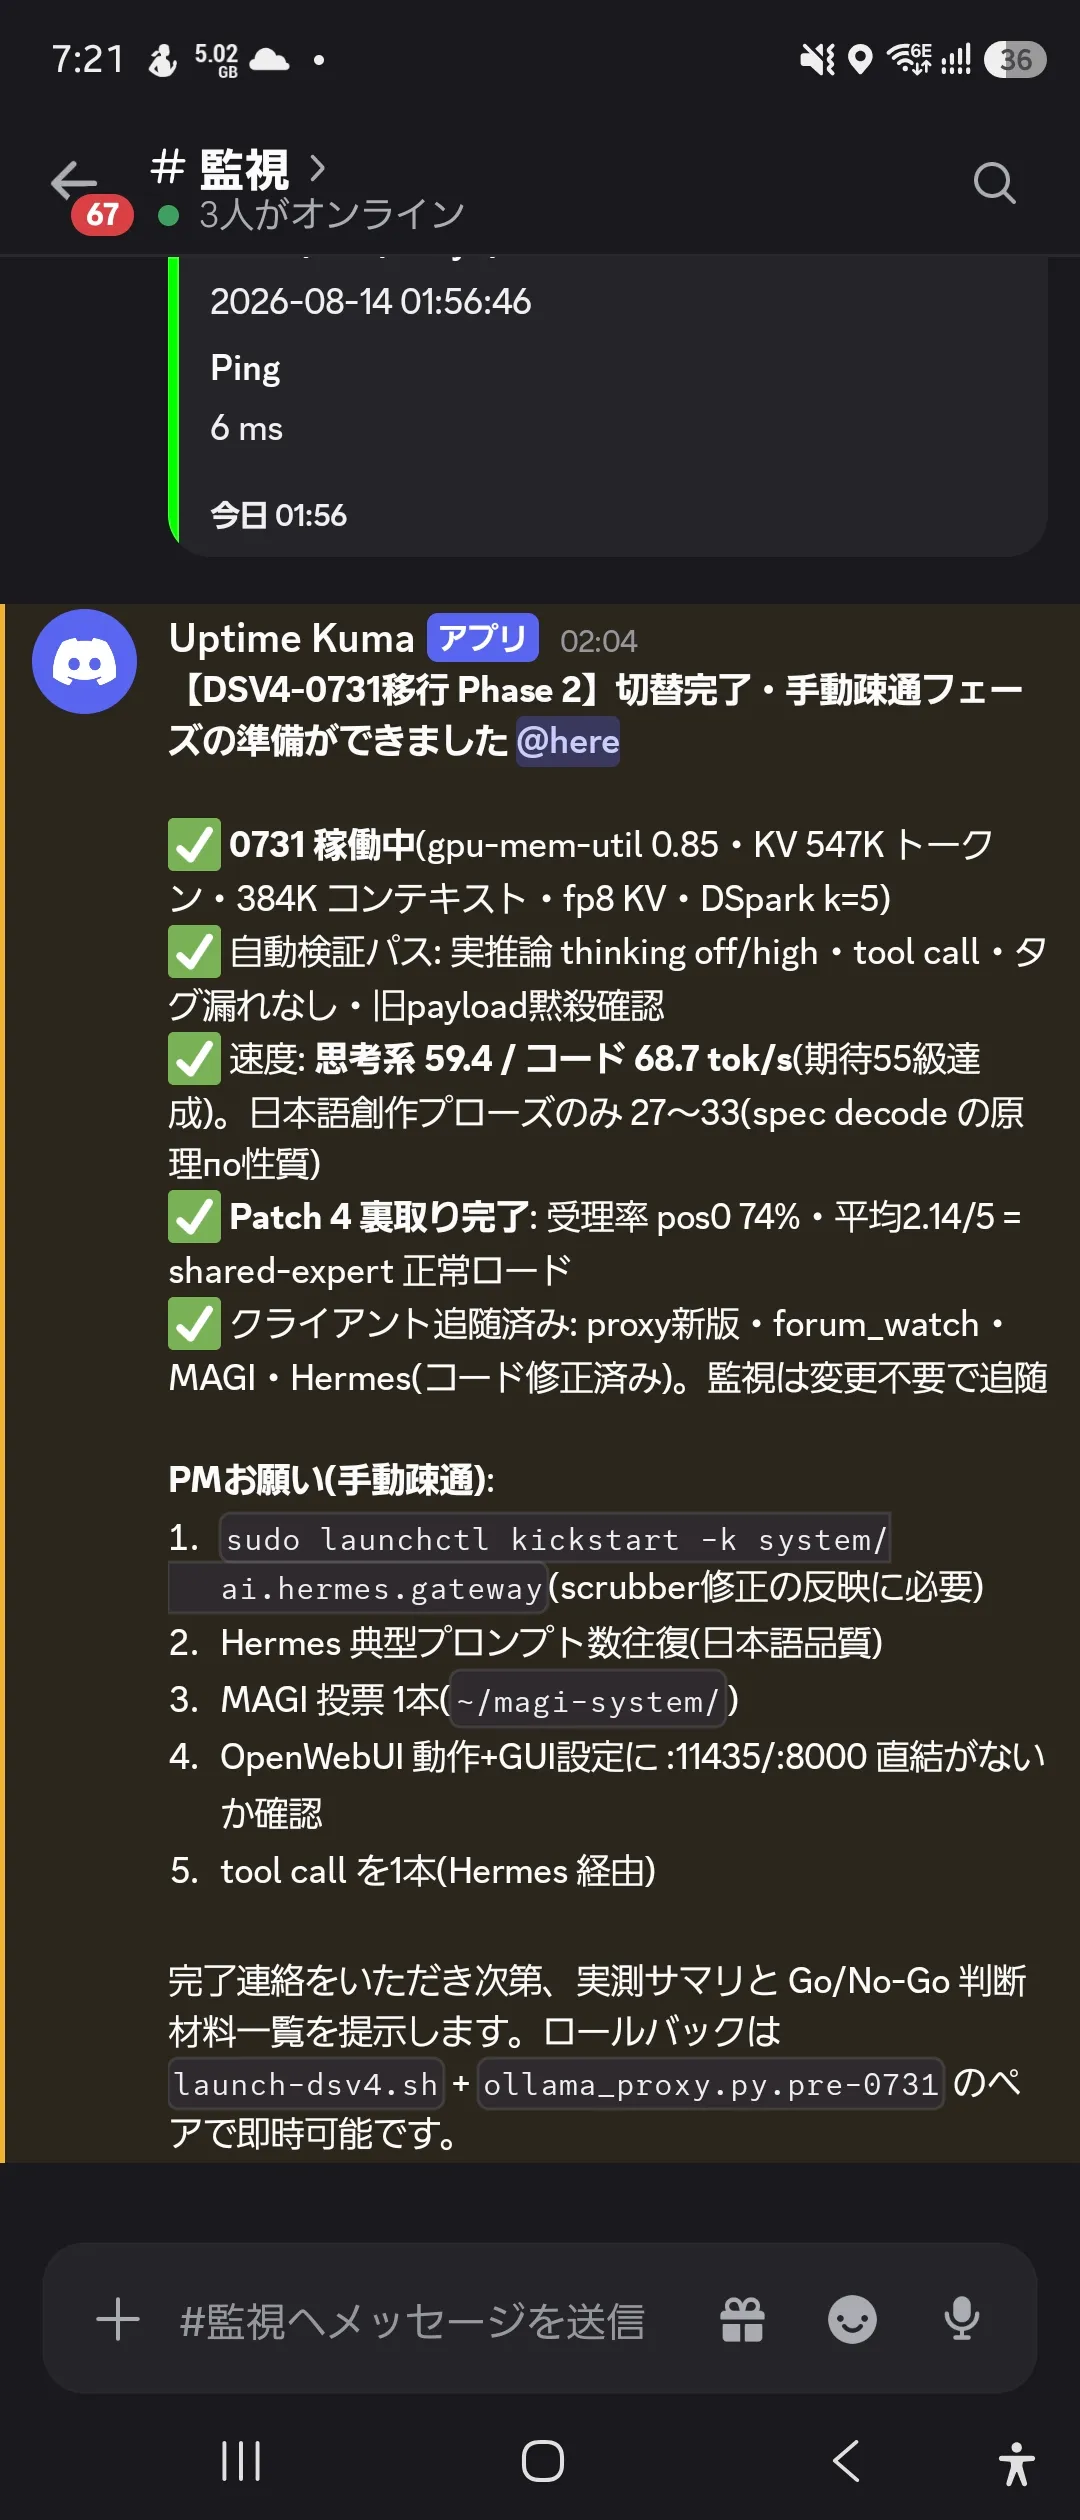
実測は、まず切替完了を告げるbotの通知として届きました。数字を表にまとめると次のとおりです。
| 項目 | preview | 0731 |
|---|---|---|
| 思考系タスク | 40〜41 tok/s | 59.4 tok/s |
| コード生成 | 40〜41 tok/s | 68.7 tok/s |
| 日本語の創作文 | (未分計測) | 27〜33 tok/s |
| ドラフト受理率(先頭位置) | — | 74% |
期待の55級に届き、Patch 4が有効であることも受理率の実測で裏が取れました。thinking漏れ(思考タグが本文に混入する既知問題)は全テストで観測ゼロ。8時間の連続稼働でエラーもゼロ。
唯一の弱点が日本語創作文の27〜33 tok/sで、これは投機的デコードの原理によるものです。ドラフトモデルの予測が当たりやすいコードや定型文は速く、予測が散る創作文は受理率が下がって遅くなる。previewのMTPも同じ性質を持っていたので、モデル間の劣化ではなくワークロード特性が可視化されただけ——と判断し、不合格ではなく「バーンイン期間の注視項目」としました。
previewの重みと起動スクリプト、プロキシの旧版はペアで温存してあり、数分でロールバックできる状態のままGo判定。翌週に安定を確認してからキャッシュを消す予定です。
終章: 移行で一番働いたのは検証だった
数字でまとめると、待機5日、実作業3日(うち停止は切替の瞬間のみ)、速度は約1.5倍、事故ゼロ。ただし振り返って一番価値があったのは載せ替えそのものではなく、その過程の検証が運用の見えない負債を3件精算したことでした。6週間の沈黙bot、上書きされた公開URL、監視の層の抜け。どれも移行がなければ、次に困る日まで眠り続けていたはずです。
今回の学びを5つ:
- 待つのも仕事。動いているものがあるなら、地雷は他人のコストで潰してもらえる。ただし着手トリガーを先に決めておくこと(でないと永遠に待つ)
- 停止窓には切替以外を残さない。分割は停止を延ばすのではなく、止まらない場所に作業を寄せるための道具
- 合格基準は二段で決めておく。期待値と合格ラインを分離しないと、中間の数字が出たときに判定が止まる
- 「監視がある」と「その層を見ている」は別。ノードは緑でもプロセスは死ねる
- 普段の動線を全部踏む検証は、新環境のテストであり、古い死角の棚卸しでもある
前回の記事で、人間に残った仕事は4つと書きました。ケーブルを挿す、判断を下す、事実に負けを認める、目的を言葉にする。今回それにひとつ追加します。判断の基準を、判断が必要になる前に決めておくこと。深夜の眠い頭は、48 tok/sが合格かどうかを考えるのに向いていません。
※文中の性能値はすべて当環境(GB10×2、TP=2、fp8 KV)の実測です。0731まわりのレシピと最適パラメータはコミュニティで日々更新されているため、再現される場合は最新の検証済み構成を確認してから着手することをおすすめします。