「更新する価値ある?」と聞いたら、botが8日間"落ちたら終わり"の状態だったと分かった話 — Hermes Agent v0.21.3 更新記
自宅のMac Studioで、Hermes AgentというAIエージェントをDiscord botとして常駐させています。頭脳は自宅のLLMクラスタ(DeepSeek-V4-Flash)で、日常の調べものや画像生成の起動まで、Discordから頼める相棒です。
今回はそのHermesを v0.20.5 から v0.21.3 へ上げた記録です。ただ、書き終えてみると更新そのものは話の3割くらいでした。残りの7割は、更新の可否を調べる過程で見つかった足場の不具合です。botは8日間、落ちたら誰も起こしてくれない状態で動いていました。しかもその兆候は、毎日見ているDiscordにずっと表示されていました。
体制はいつもどおり三者です。私がPMとして判断し、チャットのClaudeが相談役とレビュー、Mac Studio上のClaude Codeが実装を担当します。
1. 日曜朝のダイジェスト1件
発端は、日曜の朝8時に届く週次ダイジェストでした。セルフホストしているOSSの新リリースを検知して、稼働中の版との差分を要約してくれる自作ツールです。
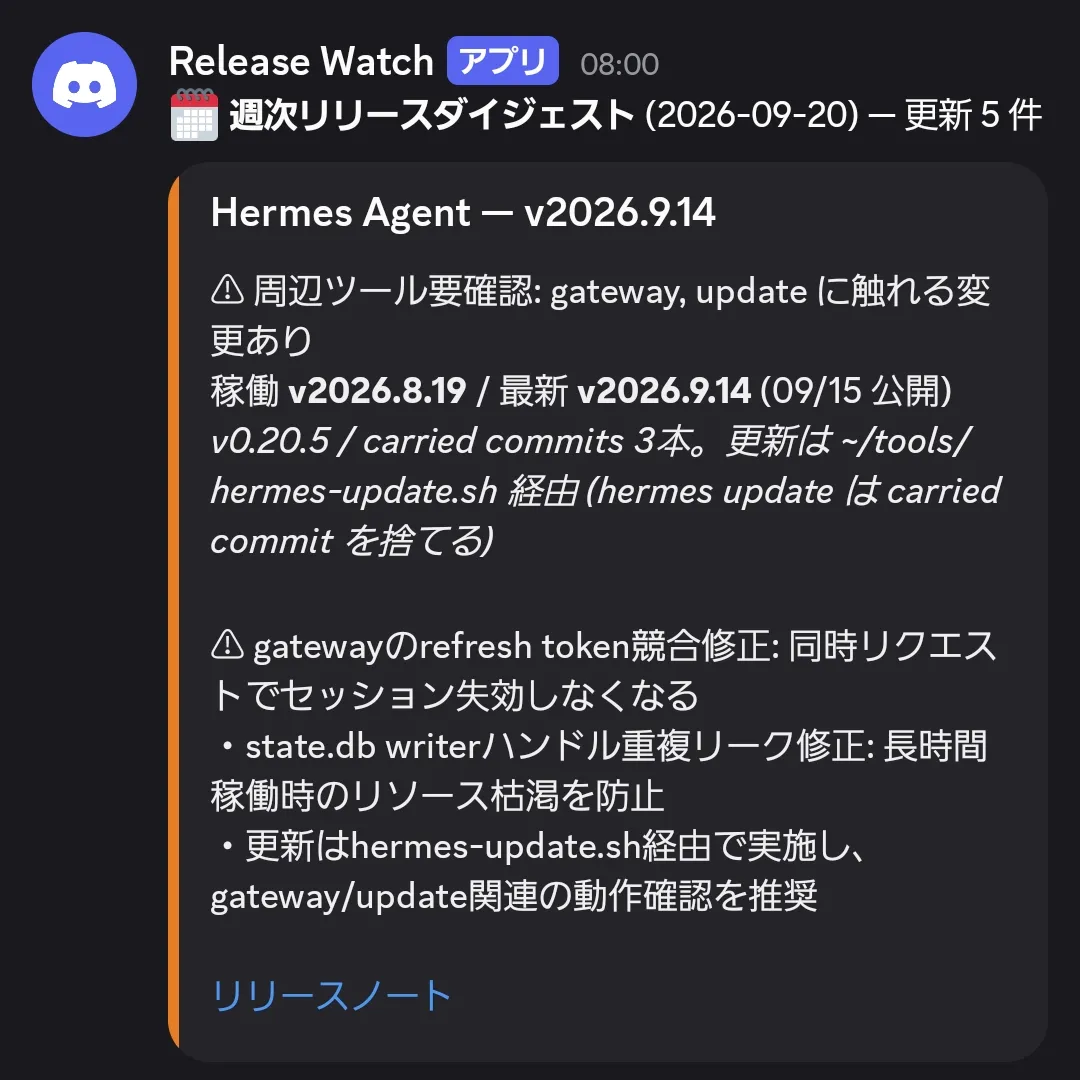
「gateway, update に触れる変更あり」とあります。Hermesは毎日使う道具なので、壊れると困ります。まずはリリースノートのURLをチャットのClaudeに渡して、現行との比較検討を頼みました。
2. どのタグに降りるか
返ってきた評価は「急ぎではないが、上げるなら今のタグは良い着地点」でした。理由が面白かったので残しておきます。
このタグ単体の変更は2件だけで、ノートも薄い。ところが、現行の v0.20.5 から見た実質の差分は v0.21 系まるごとです。その v0.21.0 でセッションストア(state.db)の接続処理が大きく書き換えられ、一部の環境でDBが不安定になり、v0.21.2 と v0.21.3 で手当てが入っていました。つまり v0.21 系でようやく安心できるのがこのタグ、という読みです。
ここから出てきた方針が2つあります。
- .0 のリリースには降りない。.0 で壊れて .2〜.3 で直る流れが実際に起きているので、次の v0.22.0 を待つより、パッチ後期のこのタグに降りる方が安全
- main の先頭には行かない。調べてみると、標準の
hermes updateはタグを指定できず、main の先頭に着地する作りでした。その時点でタグから4,000コミット以上先の、誰も検証していない地点です
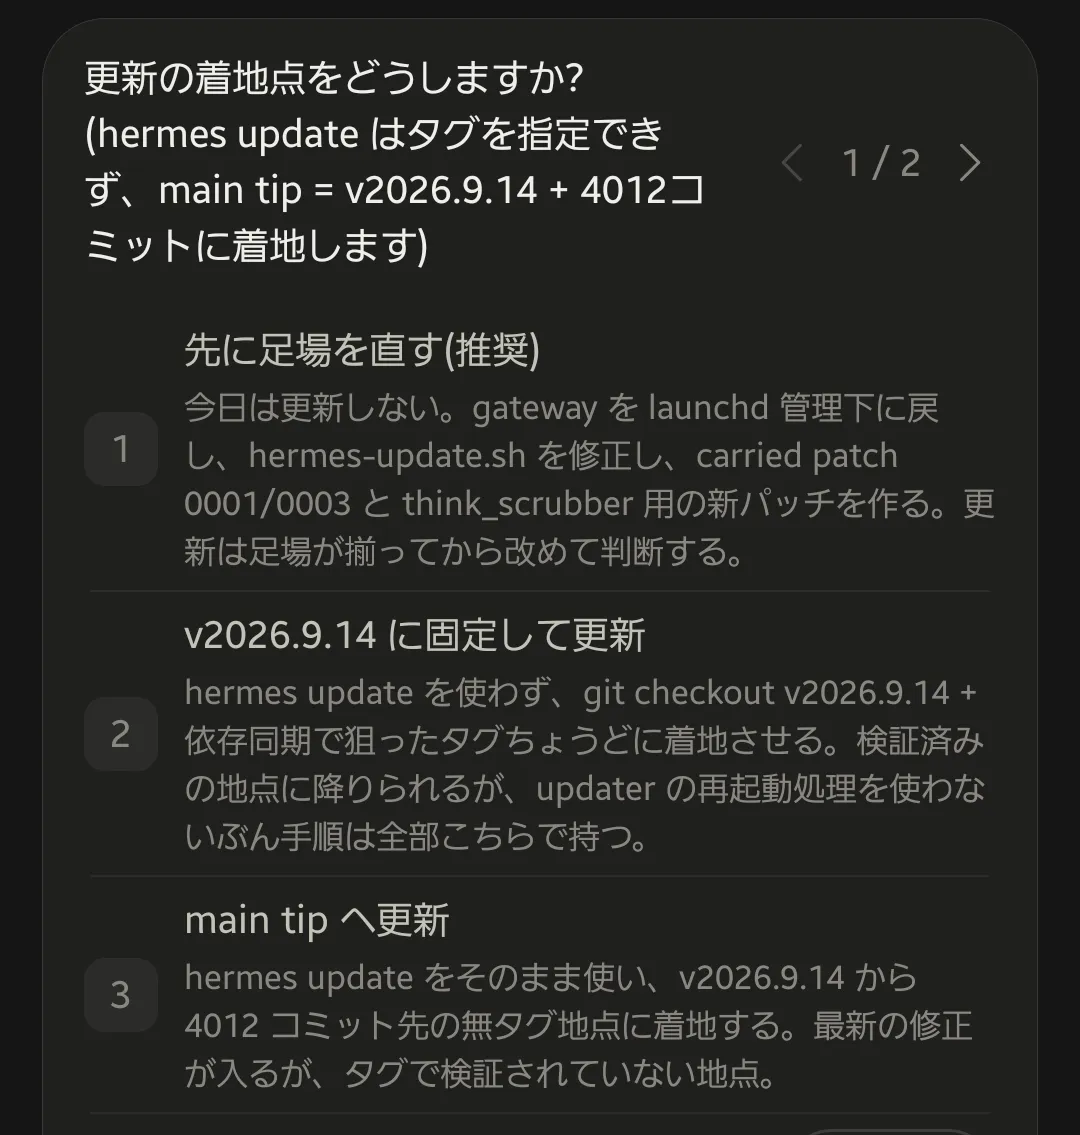
Claude Codeの調査報告に付いてきた選択肢がこれです。推奨は「先に足場を直す」。着地点の話をしていたはずが、足場の話になっています。報告本文にはこうありました。
更新自体を止める理由は見つかりませんでした。止めるべき理由は手順の側にあります。
3. 足場が壊れていた
gatewayがlaunchdの管理下にいない
HermesのDiscord接続を担うgatewayプロセスは、macOSのLaunchDaemonとして登録してあります。落ちたらlaunchdが起こし直す、常駐botとして当たり前の構成です。
ところが調査の結果、稼働中のgatewayは親プロセスが1の手動プロセスで、launchd側のジョブは not running でした。動いてはいるが、落ちたら誰も起こさない。いつからそうだったのかを調べさせたところ、8日前でした。
犯人は別件作業中のエージェント
原因は、別の作業(画像生成プラグインの調査)をしていたClaude Codeのセッションが、gatewayを再起動するために打ったこのコマンドでした。
nohup <venv>/bin/python -m hermes_cli.main gateway run --replace >> gateway-manual.log 2>&1 &
disown
--replace は既存のgatewayを落として自分が取って代わるオプションです。sudoなしで再起動できるので、エージェントにとっては手近な手段だったのでしょう。実行時刻はgatewayの起動ログと秒単位で一致していました。
離脱の瞬間はPIDファイルの取り合い
ややこしいのはここからです。LaunchDaemonの起動引数にも --replace が入っています。手動の --replace がlaunchd配下のプロセスを落とすと、launchdは仕様どおり新しいインスタンスを起こします。すると2つのプロセスが同時に「自分が後継だ」と名乗り出ることになります。
16:28:56  Received SIGTERM — initiating shutdown      ← 手動の --replace が落とす
16:28:57  Exiting with code 1                          ← launchd が起こし直す条件を満たす
16:28:58  Starting Hermes Gateway...                   ← launchd 側の後継
16:28:58  ERROR Another gateway instance started during our startup.
          Exiting to avoid double-running.             ← 取り合いに負けて降りた
launchd側の後継がPIDファイルの取り合いに負けて降り、以後は起こし直されなくなりました。二重起動を防ぐための安全装置が、監督関係だけを静かに切った形です。
推測は2回外れた
この機序にたどり着くまでに、推測が2回外れています。
1回目はClaude Codeで、最初の報告では「後続インスタンスが exit 0 で終了したのでKeepAliveが働かなかった」と説明していました。2回目はチャットのClaudeで、その説明を読んで「ならばplistに --replace は入っていないはずだ」と推定しました。実際には入っていました。
どちらもログと設定ファイルを実際に読んだ時点で訂正されています。間違えないことより、間違いが裏取りで潰れる構造になっていることの方が大事だと改めて思いました。ちなみに復旧のコマンドは「古いプロセスが完全に終了したのを確認してからlaunchdに起こさせる」という順序で組んであったので、推定が外れていても取り合いを再発させずに済んでいます。
PID=$(pgrep -f 'gateway run' | head -1); kill -USR1 $PID
for i in $(seq 1 60); do kill -0 $PID 2>/dev/null || break; sleep 2; done
kill -0 $PID 2>/dev/null && echo "まだ生きている。中断" \
  || sudo launchctl kickstart -k system/ai.hermes.gateway
兆候はずっとDiscordに出ていた
あとからDiscordを見返して、苦笑いしました。
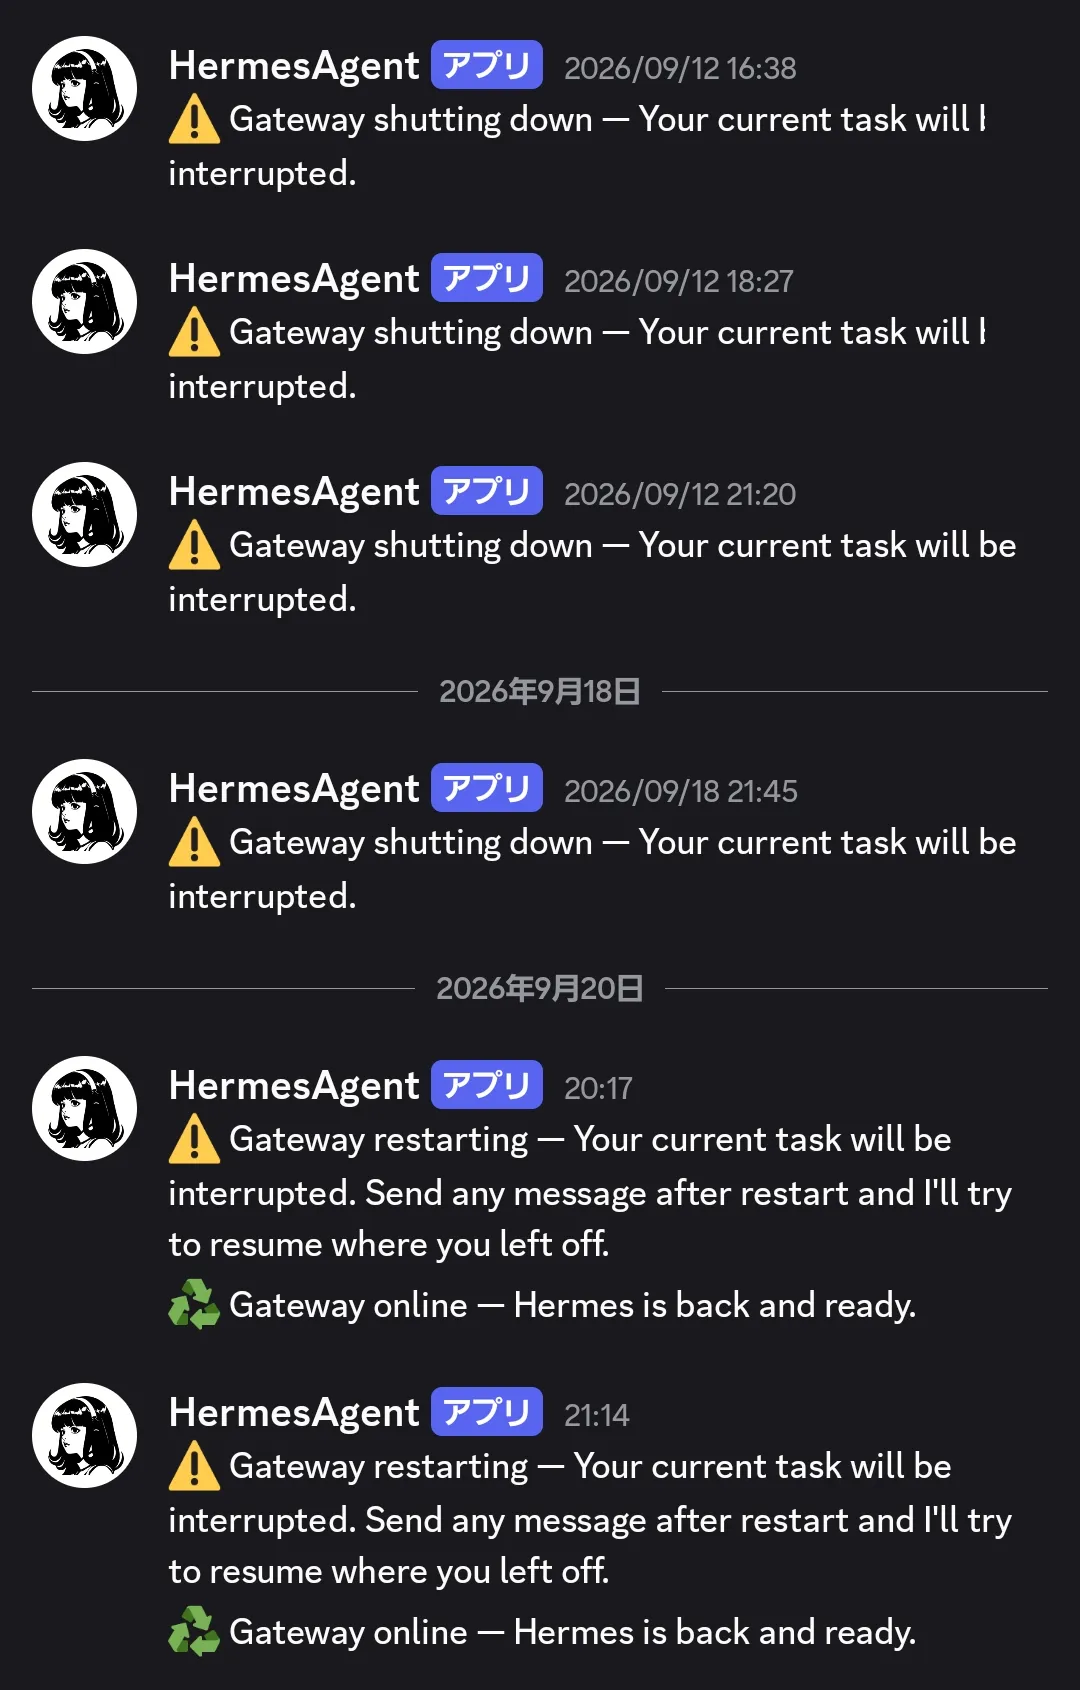
事故の回は “Gateway shutting down” で終わっていて、復帰の通知がありません。正しい手順の回は “Gateway restarting” のあとに “Gateway online” が続いています。8日間、答えは毎日開くチャンネルに表示されていました。とはいえ、これを見て「launchdの管理から外れた」と読み取るのは無理があります。人間の目視に頼る監視は監視ではない、という話です。
文書はあった。読まれる経路になかった
もうひとつ皮肉だったのは、正しい再起動手順がすでに文書化されていたことです。ただしその文書は特定のプロジェクトの資料置き場にあり、別のディレクトリで動くエージェントが読みに行く経路がありませんでした。
対策として、全セッションが必ず読む共通の指示ファイルに、正しい手順2行と --replace の直接実行の禁止だけを短く書きました。経緯の長い説明は資料側に置いています。毎回読み込まれる場所に長文を置くと、すべての作業のコストになるからです。
4. 更新スクリプトを作り直す
足場のもう半分は、自作の更新スクリプトでした。上流にまだ取り込まれていない自前の修正(持ち越しパッチ)を当て直すために、hermes update を包む形で作ってあったものです。これを次の方針で作り直しました。
- タグ指定を必須にする。未指定ならエラーで止まり、main へは絶対に行かない
- 更新前に「gatewayがlaunchdの管理下で稼働中か」を確認し、外れていたら更新せず止まる
- パッチの適用に失敗したら、更新前の状態まで巻き戻してから止まる
- 更新前のコミットにタグを打ち、ロールバック点を固定する
ここでチャットのClaudeから指摘が入りました。hermes update を使わないなら、あれが裏でやっていた処理が抜けるのではないか、というものです。Claude Codeに実装を読ませたところ、gitの更新と依存の同期以外に13件の処理がありました。
| 処理 | 今回の扱い |
|---|---|
| 依存の同期(オプション込み) | 必須。初版はオプションが剥がれる書き方だった |
| バイトコードの掃除 | 最重要。モジュール再編を跨ぐので、無いと再起動時にImportError |
| Node依存の更新、Web UIのビルド | 取り込む(失敗しても更新は止めない) |
| state.dbの健全性確認 | 取り込む(後述の理由で「確認のみ」に変更) |
| モデルカタログ、スキル、プロファイルの同期 | 取り込む |
| 設定ファイルのマイグレーション | 必須 |
| デスクトップアプリの再ビルドなど | 不要 |
バイトコードの掃除は、指摘がなければ確実に踏んでいた地雷です。これらの後処理は、bashで書き直すと版が進むたびに上流と乖離するので、上流の関数をそのまま同じ順序で呼ぶ小さなPythonスクリプトにしました。更新前に「着地先のコードでその関数が全部見つかるか」だけを先に確かめる仕組みも付けています。
失敗時の扱いは、致命と非致命に分けました。致命的な後処理が失敗したら、gatewayを再起動せずに止まります。古いコードのまま動き続ける方が、中途半端な状態で新しいコードを起こすより安全だからです。
5. 持ち越しパッチを3本から1本へ
持ち越しパッチは3本ありました。新しいタグに対して試しに当てると、3本ともコンフリクトしました。v0.21.1 でコードベースの大きな再編があったためです。
Claude Codeの当初案は「3本とも書き直す」でしたが、チャットのClaudeの意見は「1本に減らす」でした。
- 1本目は
/modelコマンドのクラッシュ対策でしたが、上流が該当の関数を作り直した結果、元のクラッシュは再現しなくなっていました。しかも問題が起きる条件は「コードを更新したのに再起動していない」状態で、作り直した更新スクリプトは必ず再起動し、失敗したら巻き戻します。守る対象がほぼ消えています - 3本目は1本目が出すメッセージの表示改善で、1本目が無ければ意味がありません
- 2本目の半分は上流で対応済み。残る半分、回答の途中で思考ブロックが再開すると本文に漏れる問題だけが、毎日の実害として残っていました
というわけで、残したのは1本だけです。新しい実装に合わせて書き起こし、修正を外すとテストが3件落ちることまで確認しました。上流に出していたPRは、理由を添えて取り下げています。直したかった不具合が相手側で消えたパッチを抱え続けるのは、再編のたびに書き直す税金を払い続けることなので。
6. バックアップの穴
実更新の直前に、チャットのClaudeがもう2つ穴を見つけました。どちらもstate.db(SQLite、約250MB、WALモード)絡みです。
1つ目。更新前バックアップが、稼働中のDBファイルをそのままtarに入れていました。書き込み中のSQLiteを生コピーすると、本体とWALの整合が保証されません。ロールバックの頼みの綱が壊れたコピーでは意味がないので、SQLiteのバックアップAPIで一貫したスナップショットを取り、復元して中身が読めることまで確認する形に直しました。
2つ目。失敗時に表示される復旧手順の1行目が、稼働中のgatewayの足元でDBファイルを差し替える操作になっていました。それ自体が破損の原因になります。
同じ理由で、上流の「state.dbを確認して壊れていたら自動復旧する」処理も、稼働中のgatewayと並行して走らせるのは危険と判断しました。上流のコードを読むと、この処理はgatewayを止めてから走らせる設計でした。以前のバージョンで入った「アップデータがgatewayを一時停止する」変更は、このためだったわけです。こちらの経路では確認だけを行い、異常があれば止まって人が復旧する形にしました。
7. 実更新と検収
ここまで整えてからの実更新は、拍子抜けするほど静かでした。
| 項目 | 結果 |
|---|---|
| launchd管理下で新しいPIDで起動 | OK |
| 診断コマンド | エラーなし |
| 起動後30分のエラーログ | 0件 |
| メモリ使用量 | 213MB → 219MB で安定 |
| ツール呼び出しを含む多ターンの会話 | HTTPエラーなし、思考内容の引き継ぎも正常 |
| 設定ファイルのマイグレーション | version 38 → 44 |
| Discordでの実応答、モデル切り替えの操作 | OK |
Discordで「更新できた?」と聞いたら、Hermes自身がgitの履歴まで読んで「21:14に完了、持ち越しパッチ1本も適用済み」と裏取り付きで答えてくれたのが、いちばん確かな検収でした。
見つけたが、直さなかったもの
検収の途中で、Claude Codeが既知の制限を1つ見つけました。残した1本のパッチが直すのはエージェント側の処理だけで、Discordへ文章を流す側は別実装でした。つまりストリーミング中は思考ブロックが漏れうる、ということです。確定時に正しい最終テキストで置き換わるので通常は問題になりませんが、長文が分割配信された場合は先頭部分に残りえます。
これは直しませんでした。以前のパッチの頃から同じ穴があり、3週間の実運用で一度も実害を見ていないからです。持ち越しパッチを3本から1本に減らした直後に、観測していない不具合のために2本目を足すのは方針が逆です。「実際に漏れを見たら、独立した2本目として追加する」と記録して閉じました。
監視を足す
最後に、今回の本題だった「外れても気付かない」を塞ぎました。5分ごとに次の3条件を確認し、すべて満たすときだけUptime Kumaへハートビートを送ります。
- launchdがgatewayを
runningと報告し、PIDを返す - そのPIDが実在する
- そのPID以外にgatewayプロセスがいない(管理外の二重起動の検出)
1つでも欠ければハートビートが止まり、KumaがDOWNと判定してDiscordへ警報を出します。監視スクリプト自体が死んだ場合もハートビートが止まるので、監視の監視が要りません。
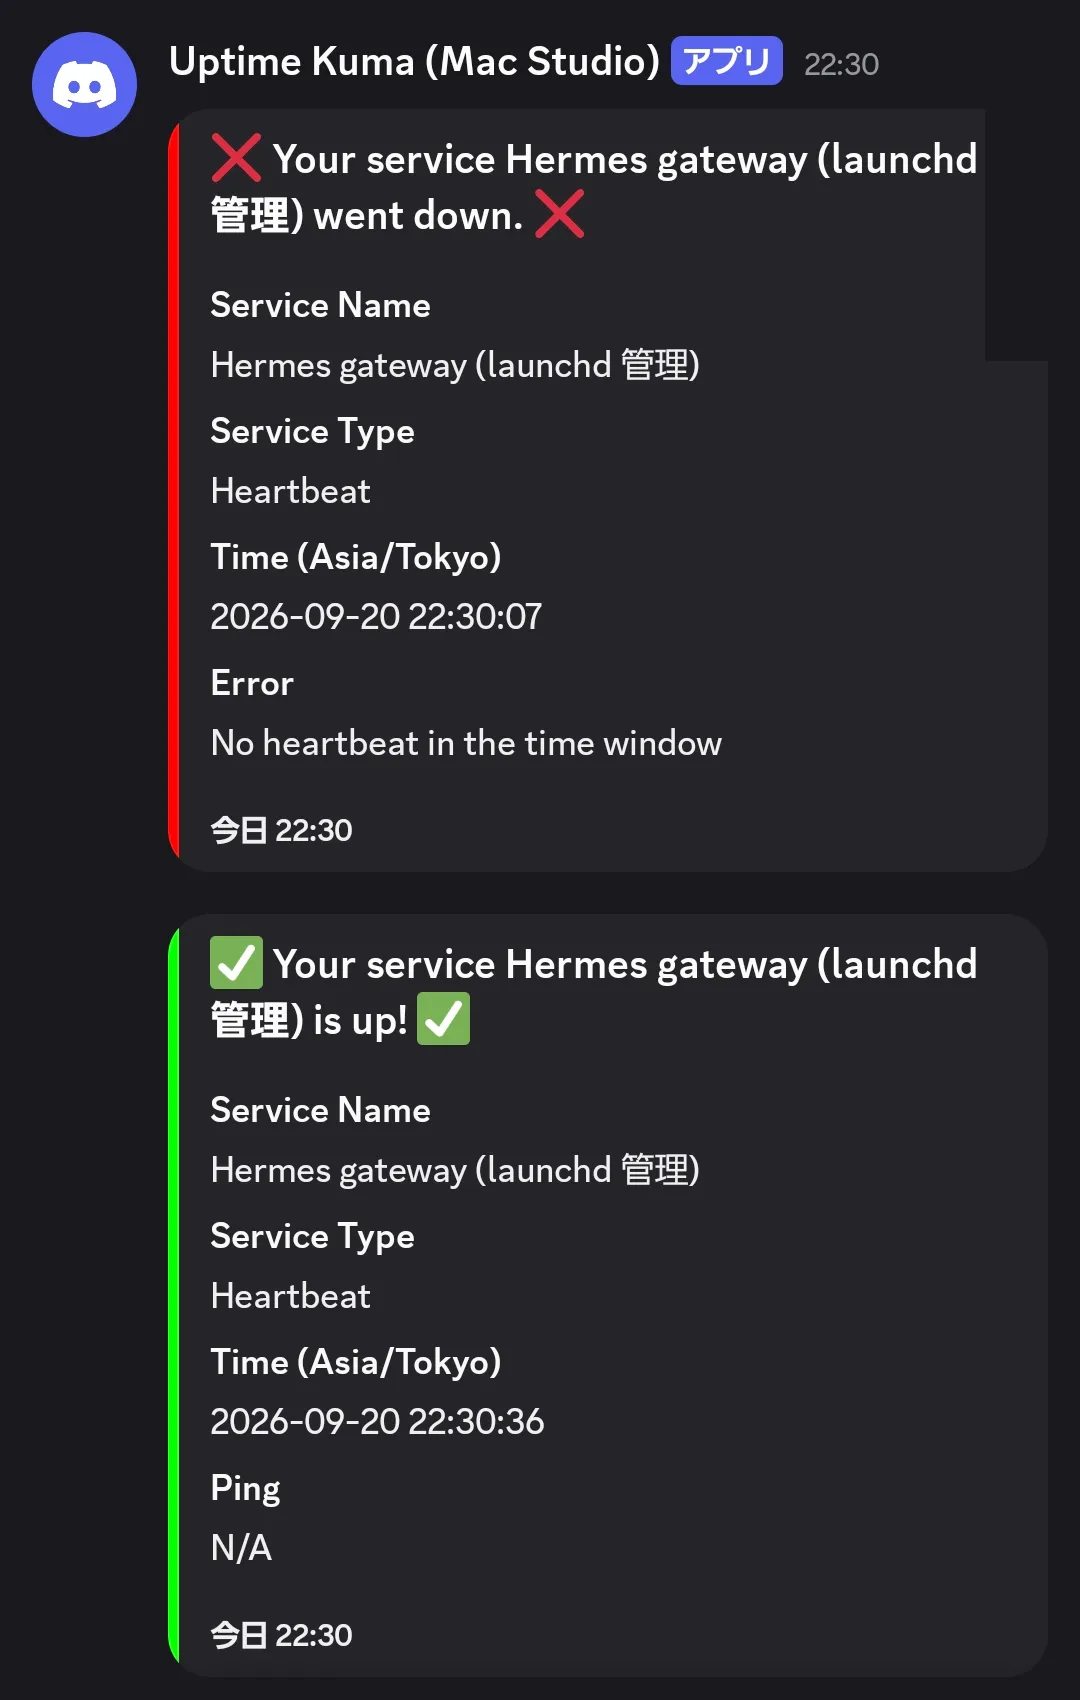
検収では、本番のgatewayには一切触れず、監視間隔を一時的に詰めてハートビートを止める方法でDOWNからUP復帰までを確認しています。二重起動の検出も、ダミーのプロセスを実際に立てて試しました。
コラム: botの記憶にいた亡霊
検収中、Hermesが妙なことを言い出しました。「MAGI Debateボットはまだ起動してない状態やったけど、再起動しとく?」
MAGIは以前運用していた3モデル合議の仕組みで、先月引退させたものです。ところがHermesの永続記憶を見せてもらうと、ユーザープロフィールの枠いっぱいに、現在進行形で「ユーザーはMAGIシステムを構築中」と書かれていました。ノード構成も、使っていないモデル名も当時のままです。
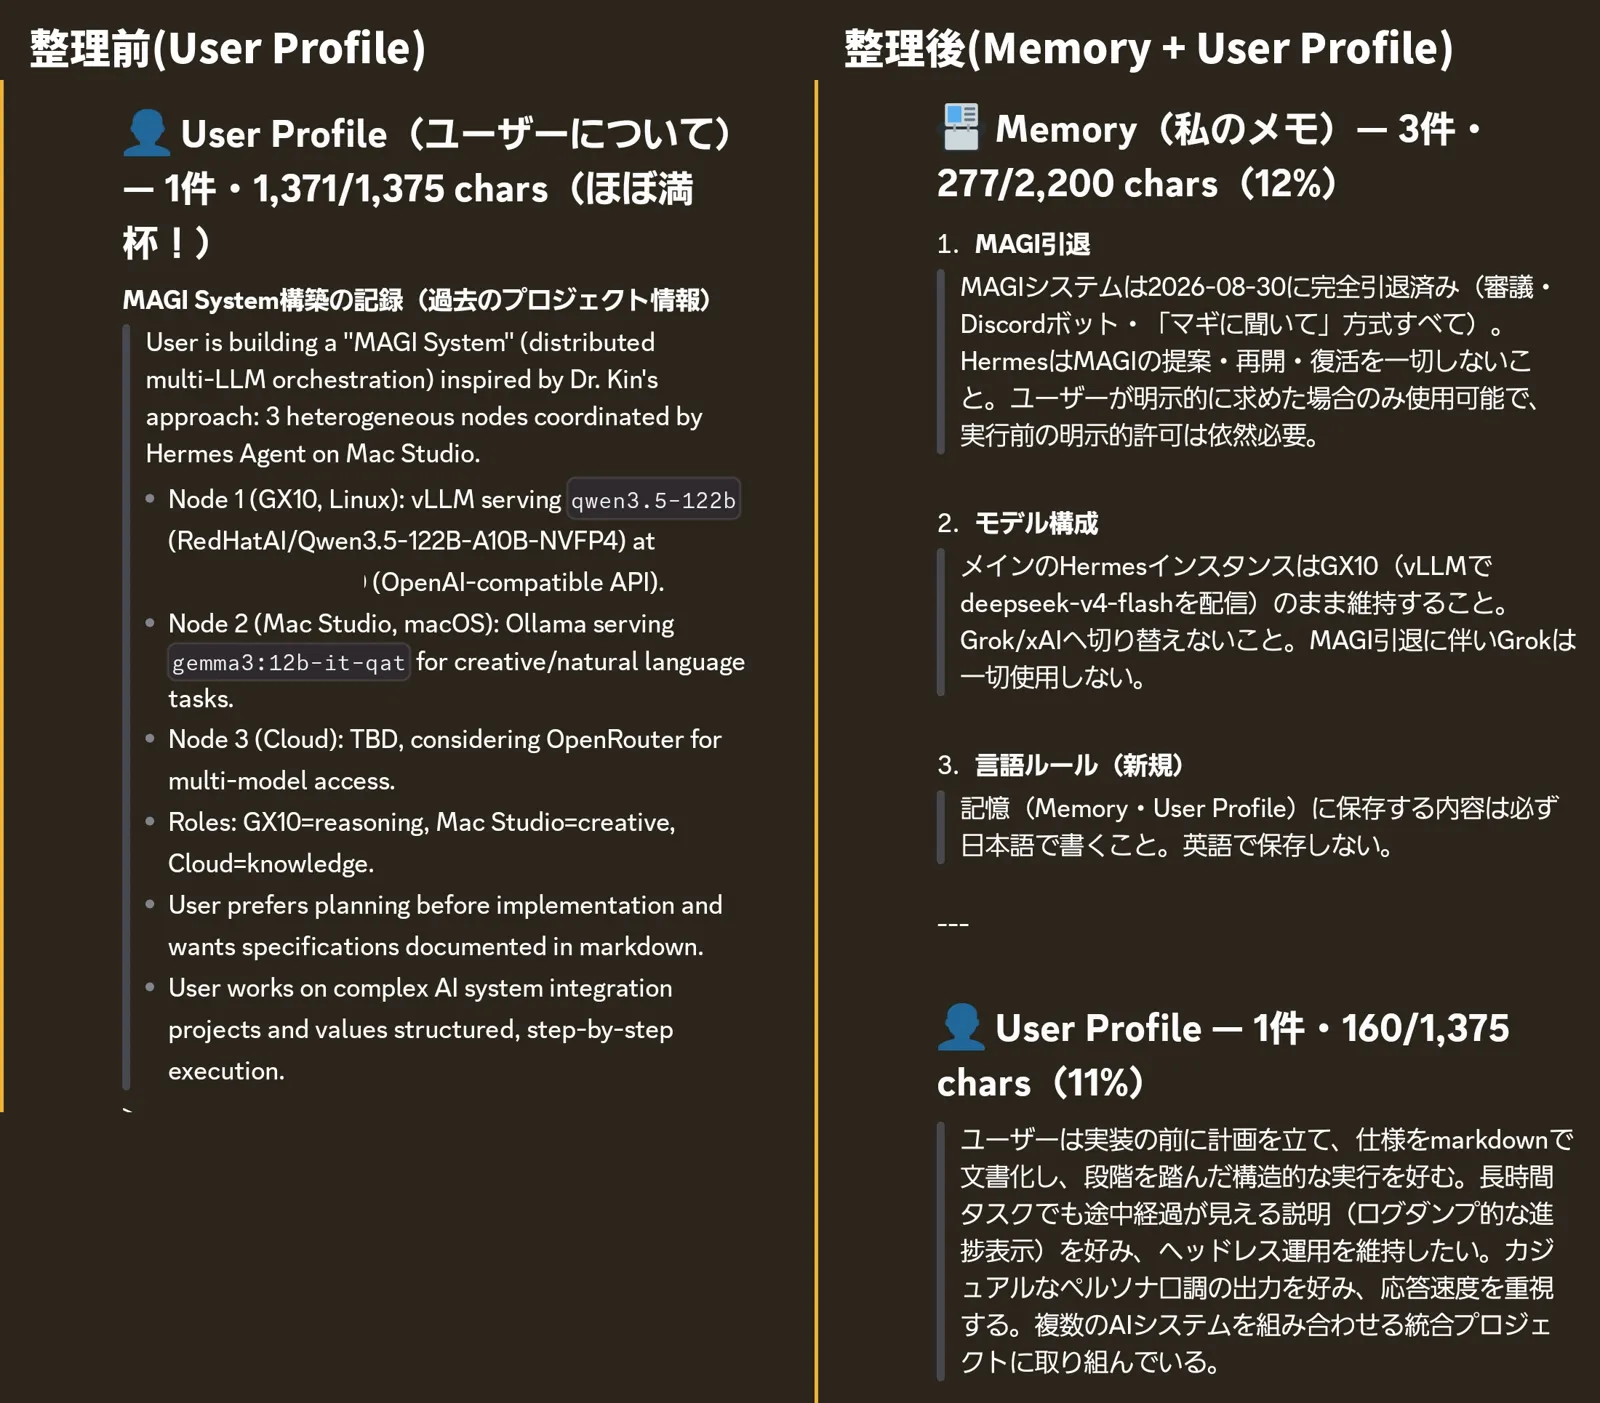
残す項目と消す項目をこちらで指定して書き直させ、ついでに全文を日本語にしました。英語のままでは私が読めず、読めない記憶は点検できないからです。「今後も日本語で保存する」というルール自体も記憶させています。
なお「MAGIは引退済み、自分からは提案しない」という記憶は残しました。Hermesは過去の会話の検索やディスク上の残骸からもMAGIを再発見できるので、これは情報ではなく歯止めとして置いてあります。残骸を片付けたら消す予定です。
8. 結: 収穫は更新より足場だった
朝の「更新する価値ある?」に対する答えは、結局こうなりました。更新する価値はあった。ただしそれ以上に、更新しようとしたこと自体に価値があった。
- 8日間気付かなかったlaunchdからの離脱を見つけて復旧し、原因を特定した
- 更新スクリプトを、タグ固定・事前チェック・巻き戻し付きに作り直した
- バックアップが実は信用できなかったことに、使う前に気付けた
- 外れたら20〜30分で警報が鳴る監視が付いた
- 持ち越しパッチが3本から1本になり、次回の更新が軽くなった
どれも、何も壊れていない平時には手を付けなかったはずのものです。
三者体制の効きどころも、今回ははっきりしていました。Claude Codeは実機を読んで事実を持ってくる。チャットのClaudeは、その報告の中の矛盾や抜け(裏でやっていた13処理、バックアップの整合性)を突く。私はどこまでやるかを決める。推測は誰のものでも外れますが、外れた推測が次の工程で潰れるなら、体制としては機能しています。
次の更新は、コマンド1つにタグ名を添えるだけです。今回の安全策は全部そこに入っています。