合計は合っているのに中身が違う —— Claude Codeに1,031ファイルのEvernote移行を任せ、4段ゲートで事故ゼロにするまで
Evernoteに14年分たまっていた1,115件のノートを、Google Driveへ移しました。作業はほぼ全部Claude Codeがやり、私はPMとして各段階の報告を読んで承認するだけ。移行そのものは3日で終わり、事故はゼロ。ただし振り返って一番学びになったのは移行の手順ではなく、AIの報告をどこまで信じ、どこで一次資料に当たるかという問題でした。タイトルの「合計は合っているのに中身が違う」はその象徴で、完了報告に書かれていた内訳の数字が2箇所間違っていたのに、合計が1,031で一致していたために誰も気づかなかった話です。
体制はいつもどおりの三人。私がPM、チャットのClaudeが相談役(ブリーフと返信案を書く)、Claude Codeが実装者。移行先の設計の話(Paperless-ngxを見送った理由と、スキャン後の自動命名の仕組み)は姉妹記事に書きました。この記事は「決まった移行先へ、どう事故なく運ぶか」の話です。
序章: 何を、どこへ
移行元はEvernoteからエクスポートしたENEXファイル14本、約1.77GB。中身を事前調査したところ、PDFが919件(うち258件はテキスト層がなく検索できない)、テキストだけのノートが92件、音声25件、Office/zip/mp4が13件、画像416件でした。画像の大半はWebクリップの断片やアプリのアイコンで、これは移行せずENEXの中に残す判断を先にしています。
移行先はGoogle Driveの Archive/YYYY/。ここには既に、スキャナから流れてくる新規PDFを「YYYY年_種別_発行元.pdf」の形にリネームして年別フォルダへ振り分ける常駐パイプライン(drive-renamer)が動いていて、過去分もこれと同じ命名・同じレイアウトに揃えるのが要件でした。つまり単なるコピーではなく、900本以上のPDFにOCRをかけ、ローカルLLMに中身を読ませて名前を付け、年を判定して振り分ける必要がある。
賭け金は前作(NASの重複190GiBの削除)とは違います。あちらは「消してはいけないものを消す」事故が怖かった。今回はコピーなので元は残る。代わりに怖いのは間違った名前・間違った年で1,000件が並んでしまい、後から直す気力が湧かないことです。取り返しがつくかどうかではなく、取り返す気になるかどうか。人間の心理まで含めれば、これも十分に事故です。
第1章: ゲートは「止まる場所」を先に決めておくもの
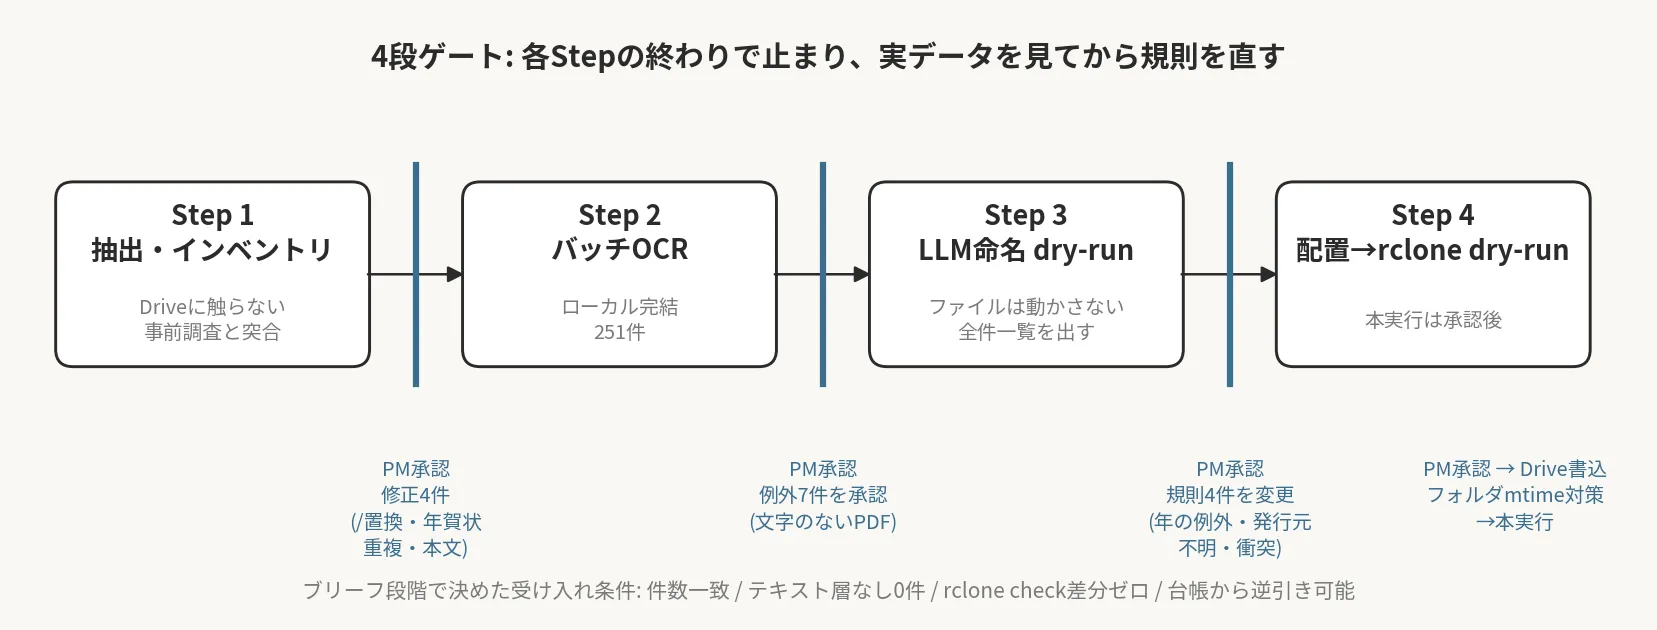
ブリーフの段階で、作業を4つのStepに割り、各Stepの終わりでPMの承認を待つと決めました。
- 抽出とインベントリ —— ENEXを走査して対象を展開し、件数を事前調査と突合する。Driveには触らない
- バッチOCR —— テキスト層のないPDFにocrmypdfをかける。ローカルで完結
- LLM命名のdry-run —— 全PDFに命名案を付けるが、ファイルは動かさない。「元タイトル→命名案」の全件一覧を出す
- 配置とアップロード —— まずrcloneの
--dry-runで件数を出し、承認後に本実行
このとき一緒に決めたのが受け入れ条件です。件数が事前調査と一致すること、アップロード時点でテキスト層のないPDFが0件であること、rclone check で差分ゼロ、manifest(移行台帳)からDrive上の全ファイルを元ノートに逆引きできること。**合格の定義を、作業を始める前に書いておく。**これをやっておくと、途中で「これは合格なのか」と悩む場面がほぼ消えます。実際、後で「OCRしてもテキストが取れないPDFが7件ある」と報告が来たとき、私は条件と照らして「例外として認める」と即答できました。条件が文章になっていなければ、その場で議論が始まっていたはずです。
ゲートは4つですが、実際に承認で止まったのは5回です。Step 1の承認時に修正を4つ出したので、「修正を反映してStep 2まで進み、まとめて報告せよ」と指示して1回分を節約し、代わりにStep 3の後に「命名案を確定してStep 4のdry-runまで進み、本実行の前で止まれ」を挟んだからです。**ゲートの数は固定ではなく、Driveに書き込む直前と、規則を変えた直後に置く。**ローカルで完結する作業は、まとめて走らせて構いません。
第2章: Step 1 —— 数字が全部一致した日に、4つ直した
最初の報告は気持ちのいいものでした。PDF 919、テキスト92、音声25、その他13、画像416。5区分すべて事前調査と一致。SHA-256で判定した重複が10件。再実行してもmanifestがバイト単位で変わらないことも確認済み。
ただしこの報告には「ブリーフから変えた点」と「判断してほしい点」が添えてあり、そこが本番でした。
**変えた点で一番大きかったのは、ENEXにノートのGUIDが入っていなかったこと。**Evernoteのエクスポートには一意なIDがなく、後からDrive上のファイルを元ノートに辿る手段がない。Claude Codeは「ENEXファイル名・何番目のノートか・作成日時・タイトル」からuuid5で決定的なIDを合成し、位置を示す列をmanifestに足していました。これは私に聞かず自分で決めて決裁メモに残してあり、正しい判断だと思います。聞かれても同じ答えをした。
一方で「ブリーフどおりに処理した結果ですが確認を」として並んでいた4項目は、読むと3つは直すべきものでした。
- タイトル中の
/を除去していたため、URLがタイトルのノートがhttp:example.com….mdのように潰れている →/:\は_に置換 - 年賀状は「ノート作成年」でフォルダ分けしていたため、「2006年賀状」というタイトルのノートがスキャンした年の
2014/に入っている → タイトルに西暦があればその年 - 本文が同じテキストノートを別々のMarkdownに出していた(同じログが3件など) → PDFと同じくハッシュで重複扱い
どれもブリーフに書いた規則をそのまま適用した結果で、Claude Codeに落ち度はありません。**規則を書いた側(私と相談役)が、実データを見るまで気づけなかった穴です。**ここで「ブリーフどおりだから承認」と流していたら、URLの潰れたファイル名12件と、間違った年の年賀状9件がDriveに並んでいました。ゲートの価値は、実行を止めることではなく、実データを見てから規則を直す時間を作ることにあります。
第3章: Step 2 —— OCR全件成功と、幽霊のような通知
OCRは対象251件(重複を除いた数)がすべて成功、10分で終わりました。日本語+英語でocrmypdfを回し、テキスト層のあるものは素通し。サイズは可逆最適化で280MBから238MBへ減っています。
ただし7件、OCRをかけてもテキストが取れないPDFが残りました。Claude Codeは先頭ページを画像に起こして目視し、「写真プリントのスキャン5件、手描きの絵1件、ほぼ白紙1件」と報告してきました。文字のない画像なので、これはOCRの取りこぼしではない。受け入れ条件の「テキスト層なし0件」に対する例外として承認し、後の命名工程ではLLMに渡さずタイトルベースの名前を付けることにしました。
この段階で、少し気味の悪い報告が混じっています。「OCR中に、実際のログと合わないバックグラウンド通知が何件か届いた」。未来の時刻を刻んだ「完了」通知、ログに存在しないファイル名の「テキストなし」通知。Claude Code自身が、その通知を採用せず ps とログとレポートの更新時刻で確かめてから報告した、と書いていました。
原因は最後まで確定していません。エージェントのバックグラウンドタスク管理の混線ではないかと思っていますが、確証はない。ここで大事なのは原因ではなく、実装者が「自分に届いた情報」と「自分で確かめた事実」を区別して報告してきたことです。これがあったので、私は以降の報告の数字を信用する根拠を持てました。
第4章: Step 3 —— LLMは「誤読した日付」に素直に従う
ここが今回の本丸です。891件のPDFに対し、テキスト冒頭をローカルLLM(DeepSeek-V4-Flash、drive-renamerと同じプロンプトをimportで流用)に渡して「YYYY年_種別_発行元.pdf」を返させる。4並列で15分。不達ゼロ。
問題は年です。ブリーフの段階で誤読ガードを入れてありました。**LLMが返した年がノート作成年より後、または3年以上前なら誤読とみなし、ノート作成年で差し替える。**dry-runのレポートには、この差し替えが起きた件を別枠で全件出すよう指示してあります。
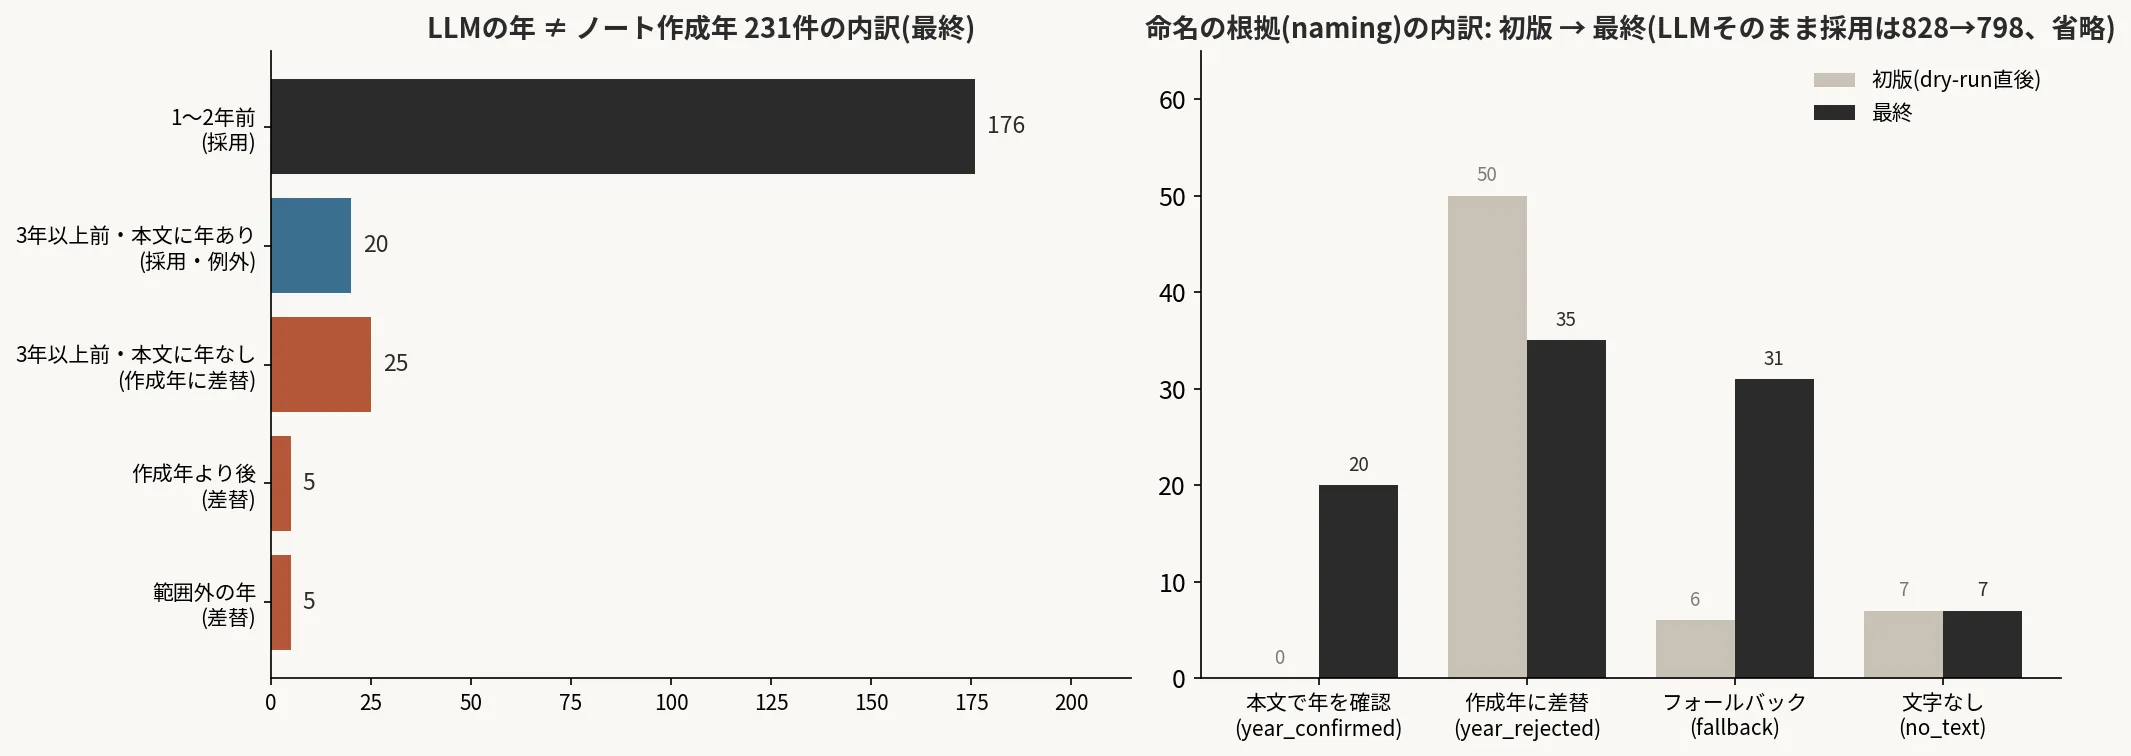
dry-run直後の集計では、LLMの年がノート作成年と違ったのは225件。うち175件は1〜2年前で、これは年末の書類を翌年スキャンした類なので問題なし。差し替えたのは50件で、レポートを読むとここに性質の違う2種類が混ざっていることが分かりました。
ひとつは本当の誤読です。原因はLLMではなく、その前段のスキャナ。ScanSnapは書類の日付を読んでタイトルに YYYYMMDD_ を付けるのですが、これを盛大に外すことがある。20000111_、20301231_、19790121_、極めつけは 11150831_(西暦1115年)。そしてLLMには「元ファイル名」としてこのタイトルを渡していたので、LLMは本文を読む前にタイトルの日付を信じてしまう。範囲外の年(1962・1963・1978・1979・2030・2031)を返してきた6件は、drive-renamerの検証で弾かれてフォールバック名になり、種別も発行元も捨てられて 2017年_19790121_(業務書類)…_文書.pdf という読めない名前になっていました。
もうひとつは、本当に古い文書です。20040401_(業務マニュアル)、20100415_自動車保険中断証明書。2010年の書類を2023年にスキャンしただけで、日付は正しい。3年ルールはこれを誤読と同じ扱いで潰してしまう。
Claude Codeは「タイトル先頭の日付とLLMの年が一致すれば採用する例外」を提案してきましたが、それだと 20000111 の誤読5件も通ってしまう。相談役と話して採用したのは、LLMの年が、PDF本文のOCRテキストの中に西暦4桁として実際に出現する場合だけ採用するという規則です。ScanSnapの誤読はタイトルにしか残らず、本文のOCRは正しく読めているはず、という読みでした。結果は的中で、本文で年を確認して救済されたのが20件。3年以上前のまま差し替えとなったのは25件で、そのうち5件が例の誤読で、残る20件は本文に西暦4桁の年が出てこないもの(和暦表記の古い書類や、本文に日付そのものがない書類)です。ここは規則では判別できず、作成年のフォルダに入っています。ここは規則の限界として受け入れました。規則の変更後に集計し直すと、作成年と違う年になったのは231件、うち1〜2年前で採用176、本文確認で採用20、差し替え35(作成年より後の5件と範囲外の5件を含む)です。
年以外にも、一覧を眺めて初めて見えた問題が2つありました。
**「発行元不明」が154件、そのうち「発行元不明_発行元不明」が31件。**同じ名前が並ぶので、衝突回避のサフィックス _2 〜 _7 の主な原因になっていました。種別も発行元も取れなかった31件はタイトルベースの名前に戻し、発行元だけ不明なものはLLMの種別にノートタイトルを添える規則にしました。ScanSnap由来のタイトルには 20160223_DTIご入会のご案内 のように中身が書いてあることが多く、LLMの「不明」より情報量があるからです。
**衝突サフィックスは連番より作成日。**歯科医院の領収証が7枚あって _2 〜 _8 では区別がつかないので、ノート作成日を _YYYYMMDD として付ける規則に変えました。176件あった衝突は138件に減り、同じ日に同じ名前が重なる31件だけが _YYYYMMDD_2 まで付いています。
LLMの呼び直しは、応答が保存されていなかった範囲外の6件だけで済みました。LLMが返した名前を llm_name 列に保存しておき、規則はその保存値から決め直す設計にしてあったからです。ここで小さな発見があって、呼び直した6件のうち1件は、同じ入力・temperature 0で今度は範囲内の2020年を返してきました。**出力は揺れる。だから規則の変更のたびにLLMを呼び直してはいけない。**保存値に規則を当てる、が正解です。
直した例をいくつか。
| 元タイトル | 初版の命名案 | 最終 |
|---|---|---|
20301231_特定口座年間取引報告書…(作成2021) |
2021年_20301231_特定口座年間取引報告書…_文書.pdf |
2020年_特定口座年間取引報告書_(証券会社).pdf |
20160126 |
2016年_発行元不明_発行元不明.pdf |
2016年_20160126.pdf |
2014年05月26日21時38分04秒(スキャン日時) |
2014年_研修名簿_発行元不明.pdf |
2010年_研修名簿.pdf(本文の年で救済) |
20210810_領収証_文書 |
2021年_領収証_(歯科医院)_4.pdf |
2021年_領収証_(歯科医院)_20210817.pdf |
第5章: Step 4 —— dry-runが拾った「既存フォルダの更新日時」
命名を確定し、ステージング領域にDriveと同じ木構造で配置(容量を増やさないためハードリンク)、全ファイルのmtimeをノート作成日時に設定してから、rclone copy --dry-run。
ここで1件、想定していなかった予定が混じっていました。**drive-renamerが既に作っていた Archive/2023 を含む27フォルダの更新日時を、rcloneが書き換えようとしていた。**ファイルには触らないが、フォルダのmodtimeは同期しようとする。実害は小さいものの、ブリーフには「既存ファイルを上書き・削除しない」としか書いておらず、フォルダの属性は盲点でした。--no-update-dir-modtime を足して再dry-runで0件を確認。既存ファイルと衝突しないことは --immutable で保険をかけています。
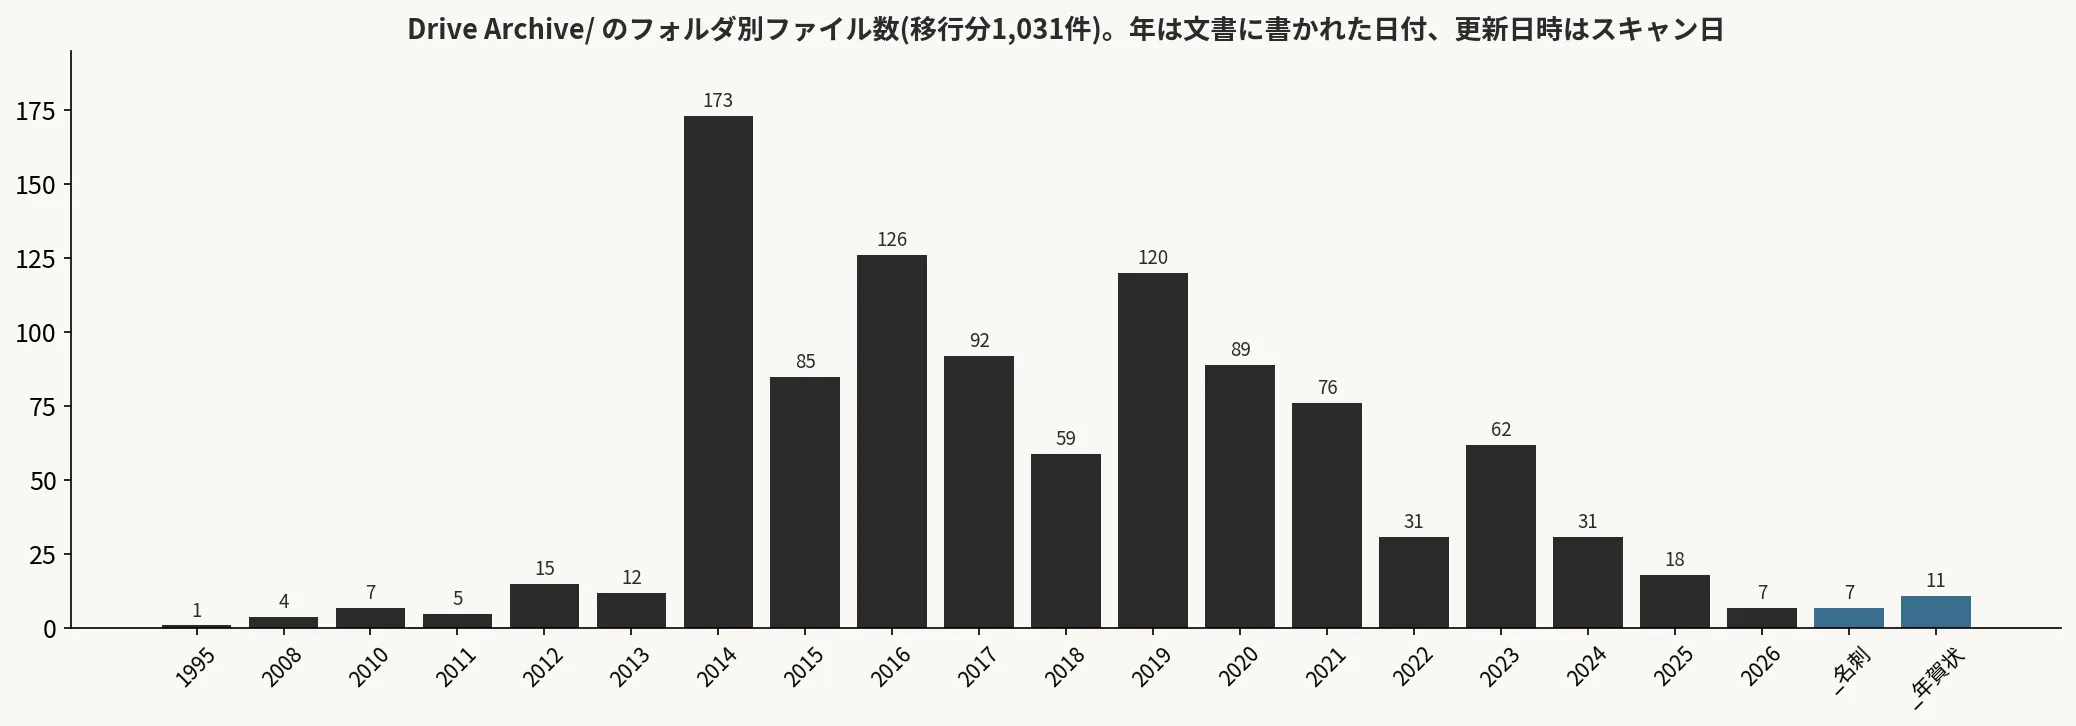
本実行は、承認を1回節約するために「dry-runが1,031件・エラー0のままなら承認を待たずに本実行へ、件数が変わったら止まれ」と指示しました。48分でアップロード完了。rclone check --one-way で差分ゼロ、全件のサイズ・MD5・更新日時が一致、Drive上の総件数は1,033(移行分1,031+台帳1+移行前からあった1)。フォルダごとに2件ずつ抜いた47件のサンプルで、Driveの「最終更新」がノート作成日時になっていることも確認。台帳のCSVはDriveの Archive/ 直下にも置き、Drive上のどのファイルからでも元のノートに戻れる状態にしました。
第6章: 合計は合っているのに中身が違う
完了後、ブログ用の素材をrepoの一次資料から抜き出させたところ、Claude Codeからこう報告が来ました。
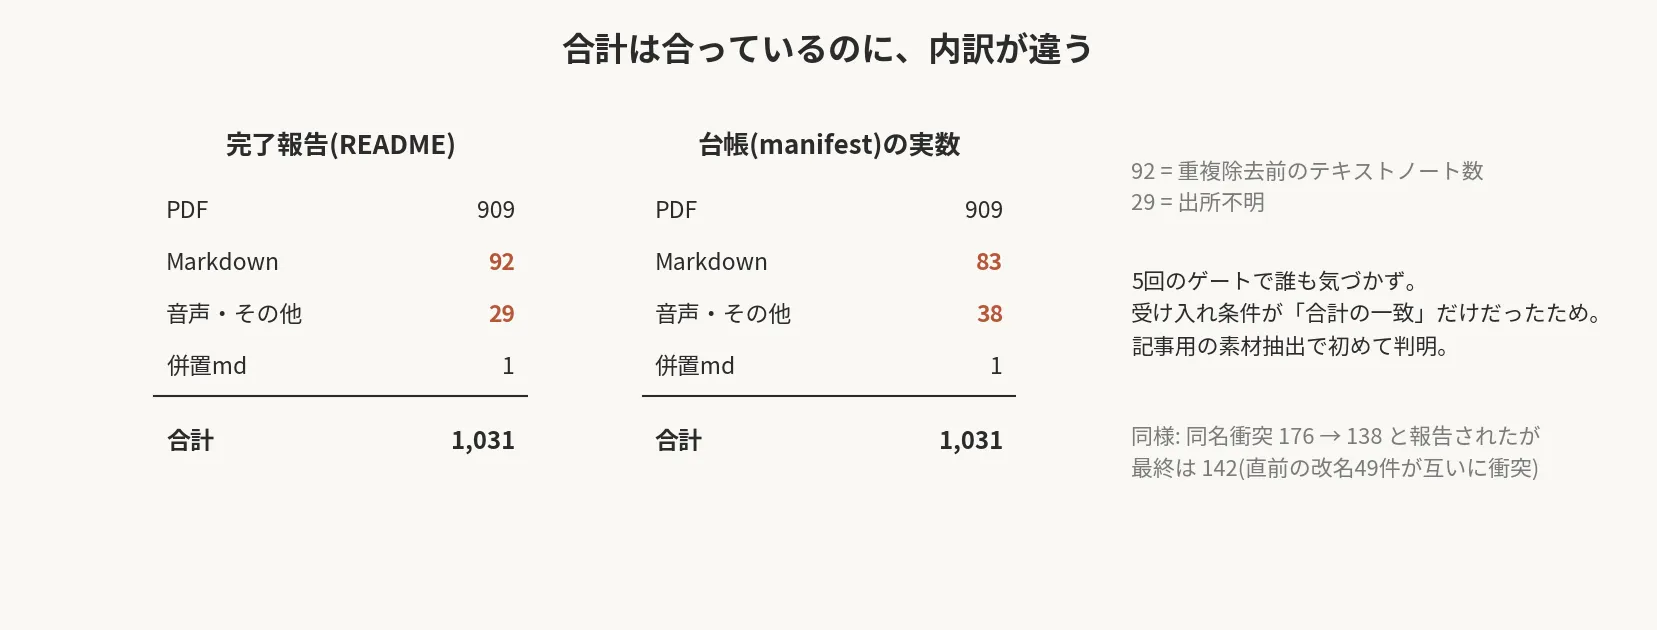
READMEの完了行の件数が間違っていました。「Markdown 92・音声等 29」と書いていましたが、manifestの実数はMarkdown 83・音声等 38です。合計がたまたま同じ1,031だったので見落としていました。
92は重複除去前のテキストノート数、29はどこから来たのか分からない。合計だけ合っていた。私はこの報告を5回の承認のたびに読んでいて、気づいていません。相談役のClaudeも気づいていない。受け入れ条件に「合計が一致」しか書いていなかったので、内訳が狂っていても誰も見なかったのです。
同じ種類の話がもう1つ。同名衝突の件数は176→138と報告されていたのですが、最終的には142件でした。Step 4直前のスキャン日時タイトル修正で改名した49件が、互いに新しく衝突していた。これも報告には書かれておらず、素材抽出で初めて出てきた数字です。
そしてrepoに記録が残っていない事象が4つあると、Claude Code自身が申告してきました。本文ありノートの数え違い(1,023件と出たが実際は113件)、例の幽霊通知、終了待ちのループが自分自身のプロセスに一致して永遠に終わらなかった件、初版の「発行元不明」154件。すべて作業中のやり取りにしか残っておらず、決裁メモにもレポートにもない。
10本の決裁メモと5本のレポートを残しても、こぼれるものはこぼれる。これは記録の怠慢ではなく、「何を記録すべきか」は事後にしか分からないという構造の問題だと思います。だから記事化のたびにこうして「repoから事実だけ抜き出せ」と一度回すのは、記事のためだけでなく、記録の穴を見つける監査として機能しています。
終章: 学び
数字でまとめると、1,115ノート→1,031ファイル・1.087GiB、実作業3日、ゲート5回、規則の変更10回、決裁メモ10本、テスト48件、事故ゼロ、そして完了報告の誤り2箇所。
- **合格の定義は作業前に文章にする。**ただし「合計が一致」は弱い条件で、内訳まで書かないと内訳は誰も見ない
- **ゲートは実行を止めるためでなく、実データを見てから規則を直す時間を作るためにある。**ブリーフの規則は、実データに当てるまで穴が見えない
- **前段の誤りは後段のAIが素直に引き継ぐ。**スキャナの日付誤読をLLMは疑わない。ガードは「本文に根拠があるか」で作る
- **LLMの出力は保存し、規則は保存値に当てる。**温度0でも揺れる。規則を変えるたびに呼び直すと、別の問題が生まれる
- AIの報告は一次資料で確かめる、を仕組みにする。「実装者が通知を疑ってログで確かめた」は信用の根拠になるが、それでも合計しか見ていなければ内訳の誤りは通る。記事化の素材抽出は、記録の監査を兼ねる
前作で「消すものは人が承認する」と書きました。今回それに足すなら、AIが数字を報告してきたら、合計ではなく内訳を見る。合計は合うものです。
※文中のファイル名の一部は、個人名・医療機関名などを伏せています。使ったツールはocrmypdf、rclone、lxml、ローカルLLMはDeepSeek-V4-Flash(vLLM)。移行先の設計(Paperless-ngxを見送ってDriveに一本化した理由、スキャナからの流入を自動処理するdrive-renamer)は「Evernoteをやめて、書類の墓場をGoogle Driveに一本化した」へ。